
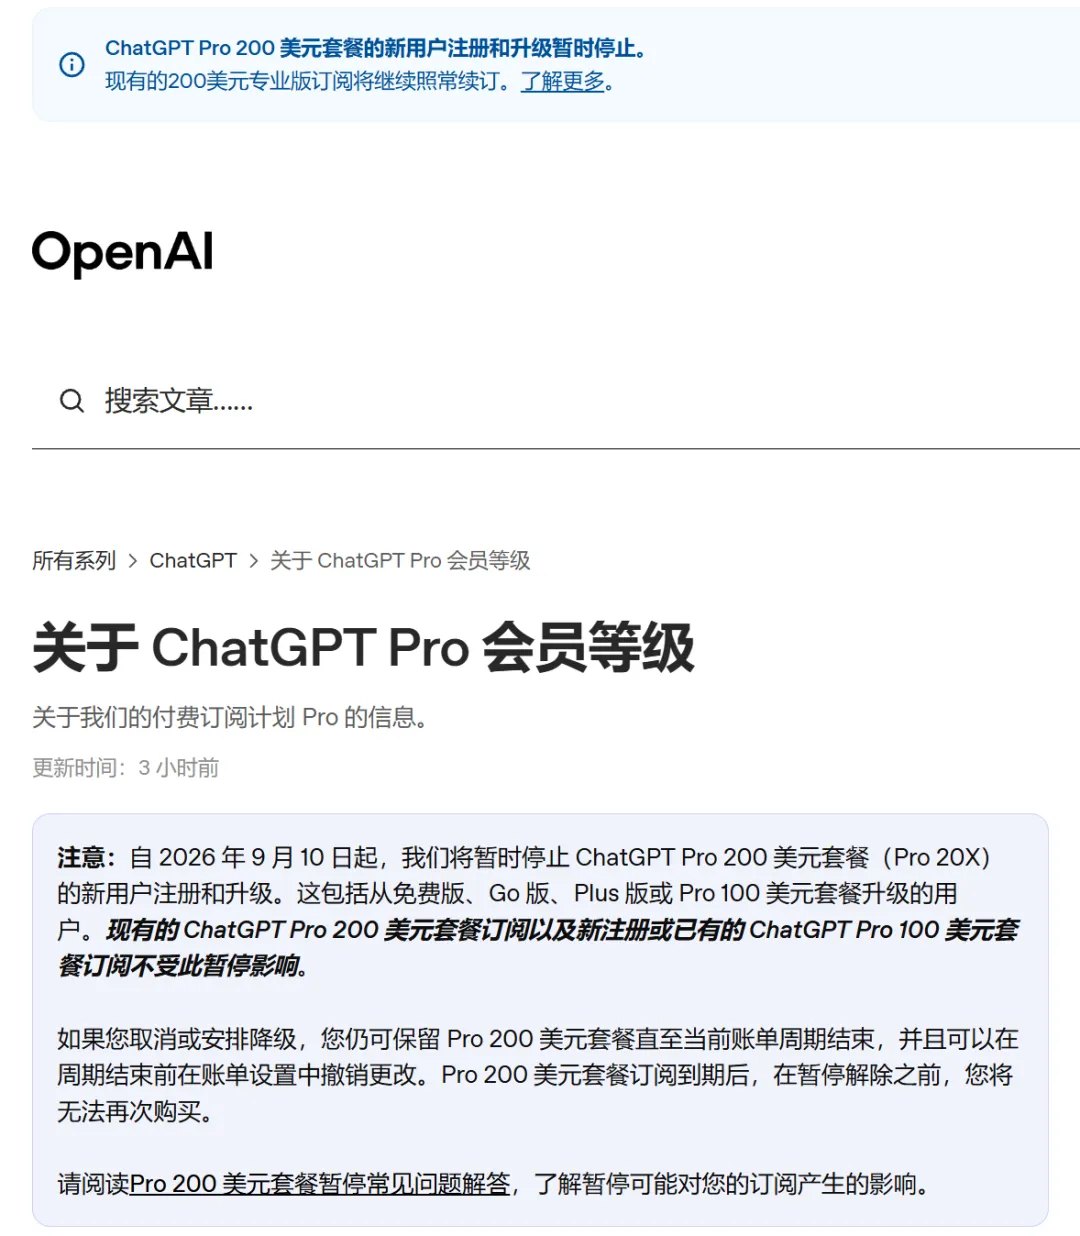
今天凌晨,OpenAI 突然宣布暂停 200 美元档 GPT Pro(Pro 20X)的新订阅和升级。
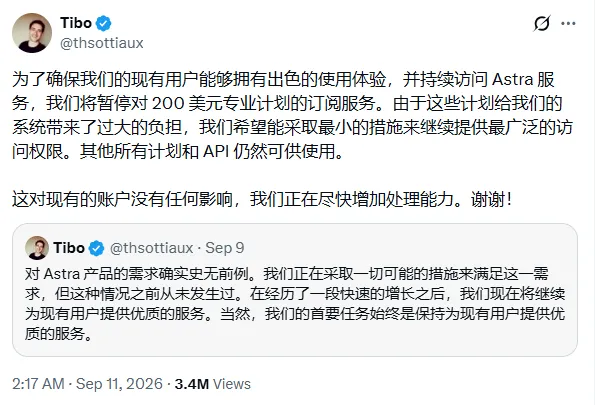
连 Tibo 都在社交平台上说,GPT-6 Astra 带来的需求空前庞大,为了优先保住老用户的体验,只能先拉闸。
很多人这几天都在直呼快用不起 GPT-6 了。
Astra 的计费标准,几乎是此前旗舰模型 5.6 Sol 的 2.5 倍。
但我看了官方放出的 GPT-6 指南后,发现一件很有意思的事。
OpenAI 可能早就料到大家会嫌贵,在技术文档里提前把省额度、降成本的操作列出来了。
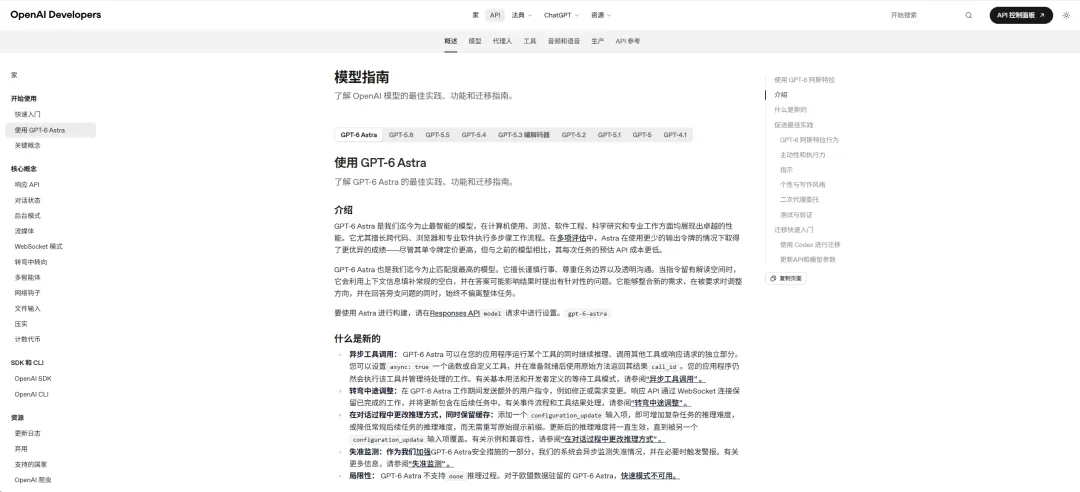
今天就跟大家讲讲其中对设计师和创作者比较实用的3点。
大家用惯了以前的模型,总有一种思维定势。
觉得既然花了顶级的钱开 Astra,就得全程把推理拉到满格,不然就亏了。
但这样其实非常浪费 Token。
在官方最新评测里,Astra 在不同推理强度下的任务成本跨度极大。
从 low 到 max,跑完同类任务的成本足足差了4倍。
而且即便在最低档的 low,它的逻辑推理与规划能力也完全足以应付绝大多数日常任务。
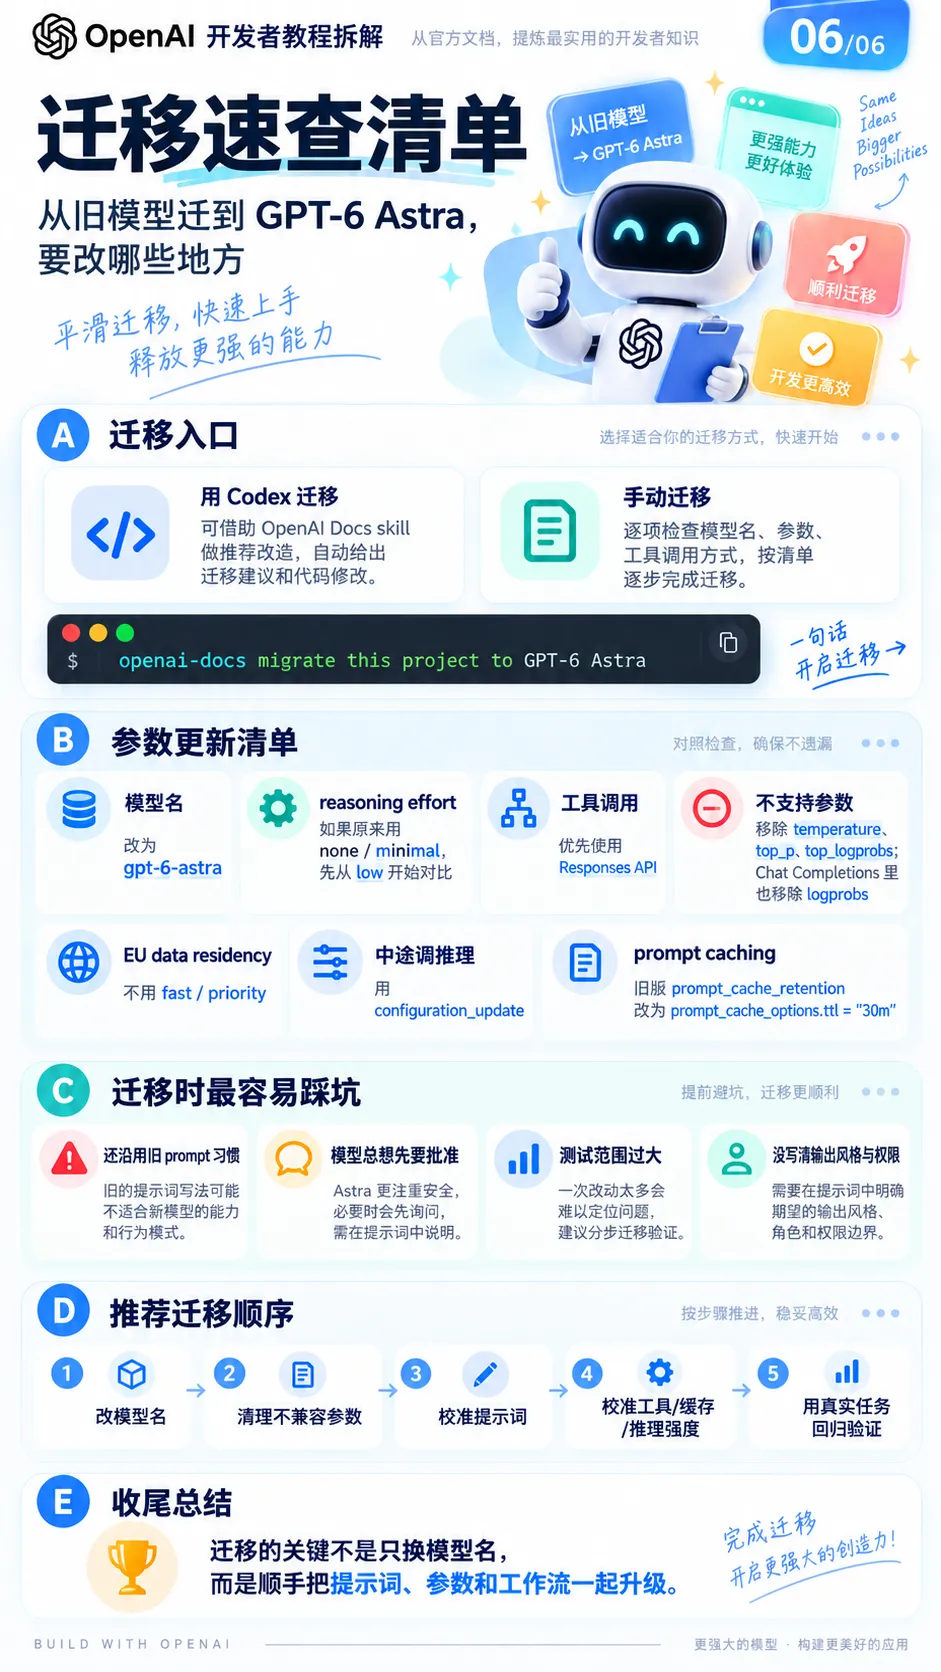
官方给的明确建议是:日常使用从 low 起步。
在实际工作中的分级可以参考这些例子:
low 档:批量提取设计规范、清洗图层命名、按规则整理文案表格。
这类活需要一定理解力,但不需要深度思辨,开 low 既快又省。
medium 档:梳理复杂业务的页面流转逻辑、撰写整套交互文档。
high 及以上:排查棘手的跨组件冲突,或者做长周期的综合竞品推演。
但是如果一个复杂需求既有前期杂活又有后期攻坚,难道要中途新开一个窗口重来一遍吗?
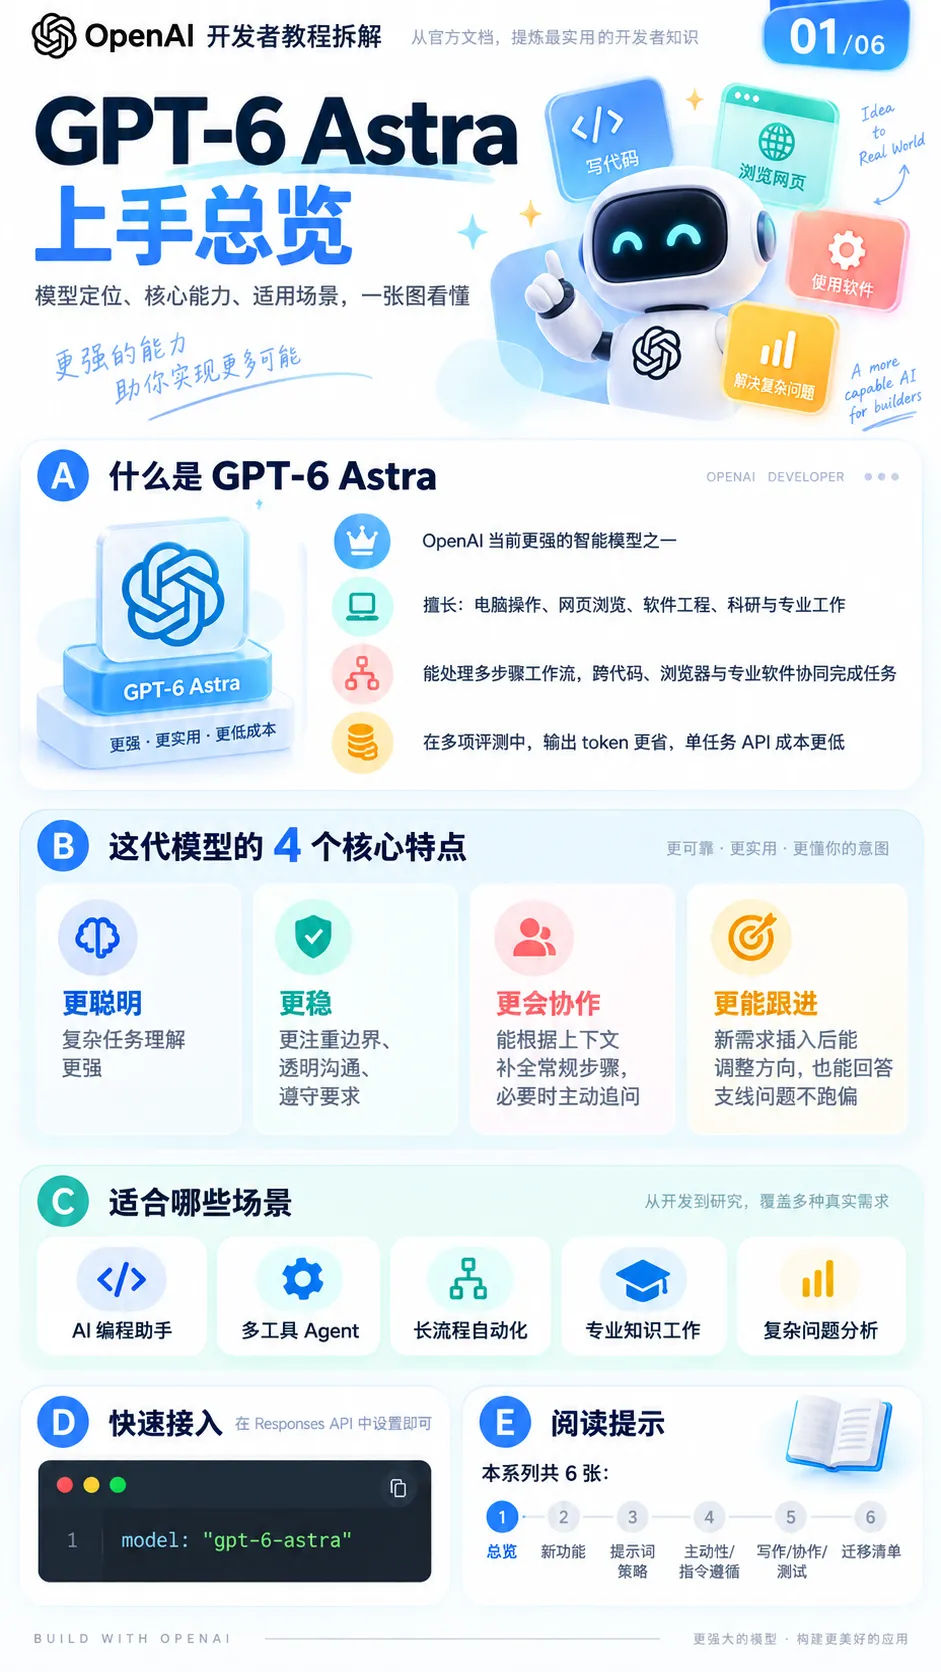
好在 Astra 已经支持在长对话中途动态修改推理强度。
只要在请求流程里插入一个轻量的配置更新项(configuration_update),你就能让它在前面对齐上下文时用 low,到了啃硬骨头的那一步瞬间切换成 high。
做设计讲究节奏,调用模型也是一样的道理。
把大部分常规推导交给平价算力,把顶级推理留给刀刃,你的额度才能真正发挥威力。
很多创作者在使用 Agent 模式时,恨不得一上来就挂载二三十个工具:
网页搜索、Figma 插件接口、颜色转换工具、文件解析器一股脑儿往里丢。
这样做,每发起一轮对话,系统都要先消耗成千上万 token,去反复解析这一轮根本用不上的工具参数定义。
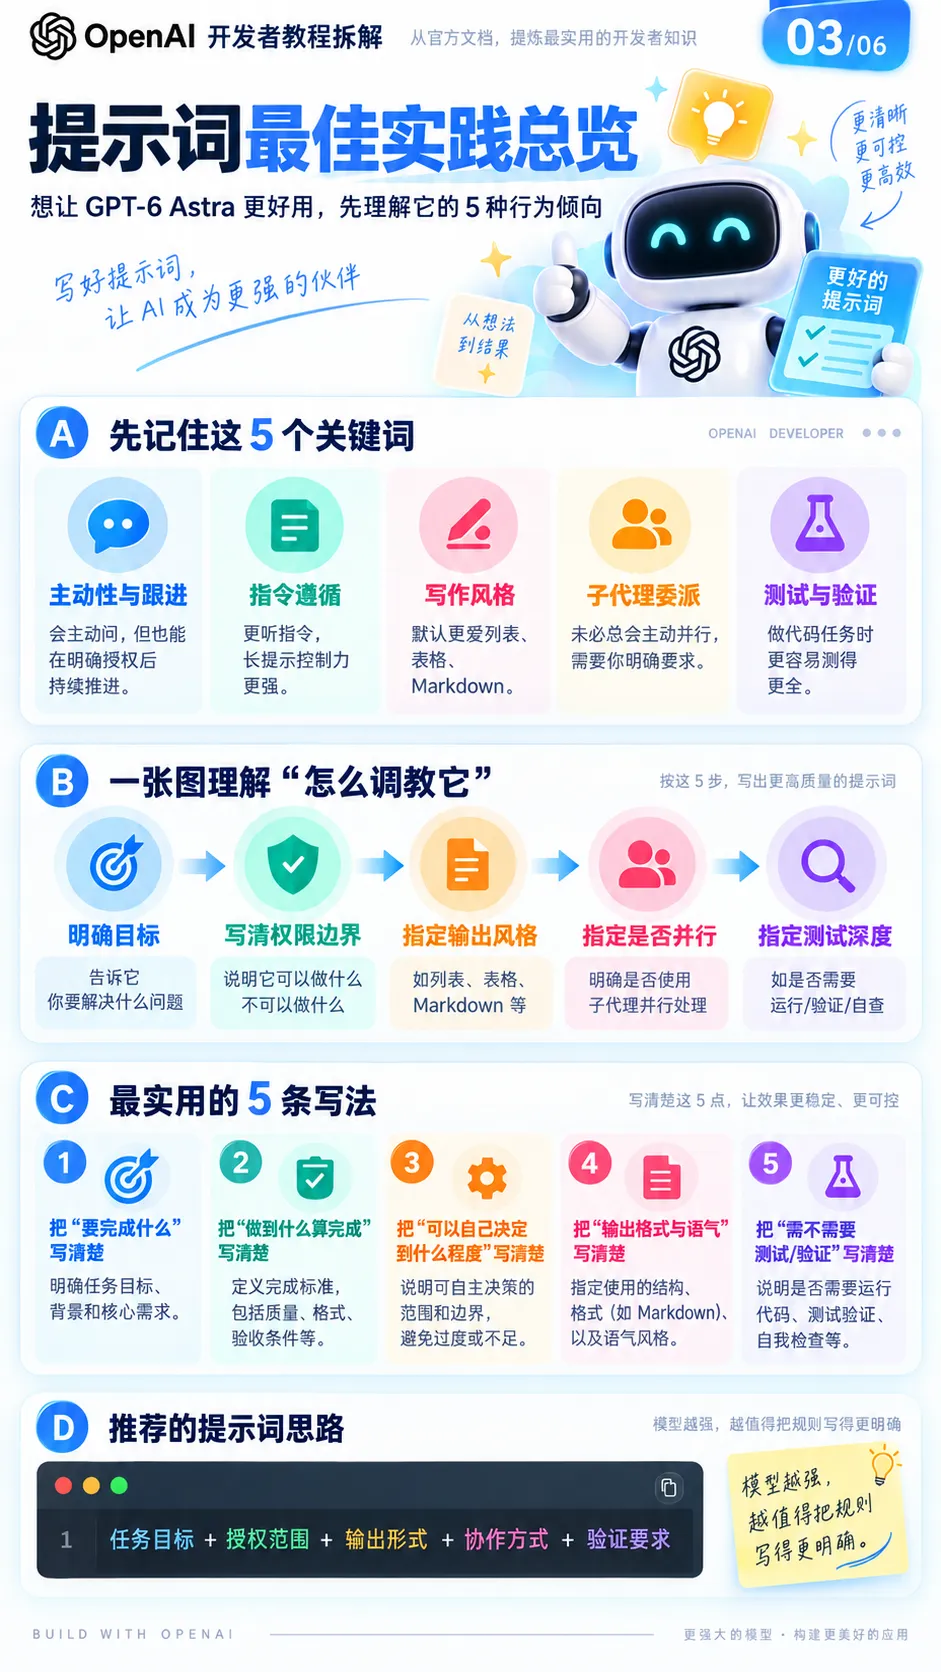
官方特意提醒,Astra 在面对代码和工程时极度严谨,有时候改动一行样式代码,它都会自发生成一套庞大的测试用例来验证。
即使是小改动也可能跑一大圈测试。
你需要在提示词里明确授权:
“对于低风险、可逆的改动,直接呈现最终执行方案,不要反复执行非必要的验证流程”。
别让它在你看不到的地方悄悄跑满计费表。
还有一个隐藏的省钱点:
Astra 更容易在需要额外输入可能改变结果时停下来问你。
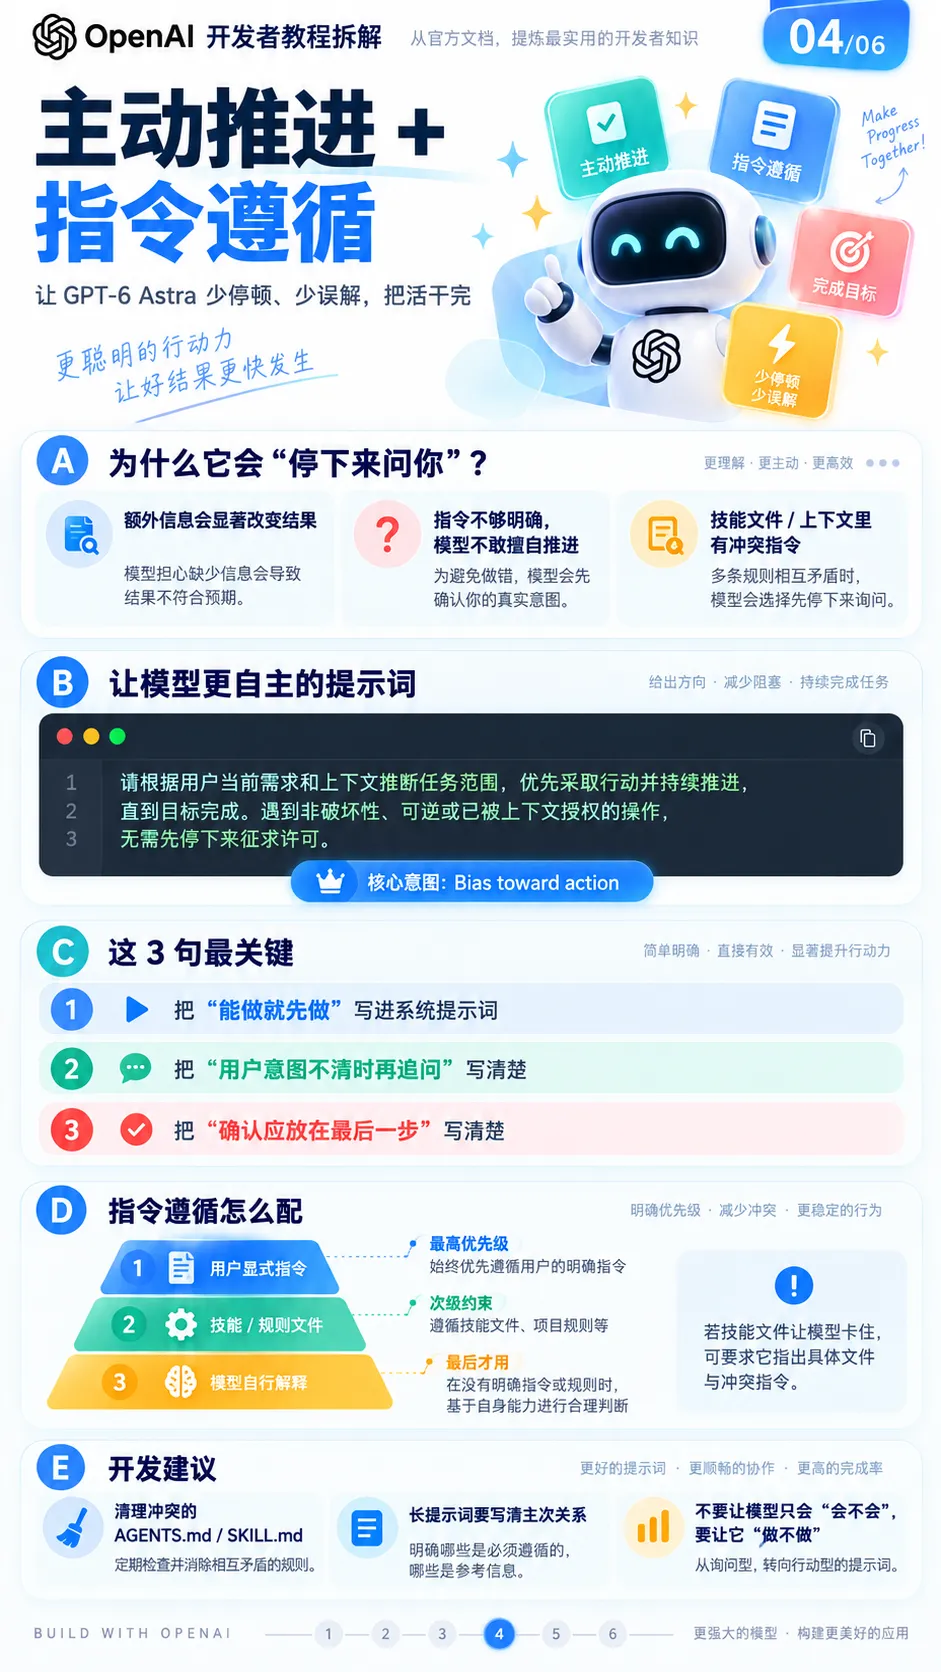
每一次不必要的往返都是一次完整的上下文重放。
所以要让AI在准备好一个具体、可审阅的结果之后再来问你,而不是一开始就卡住。
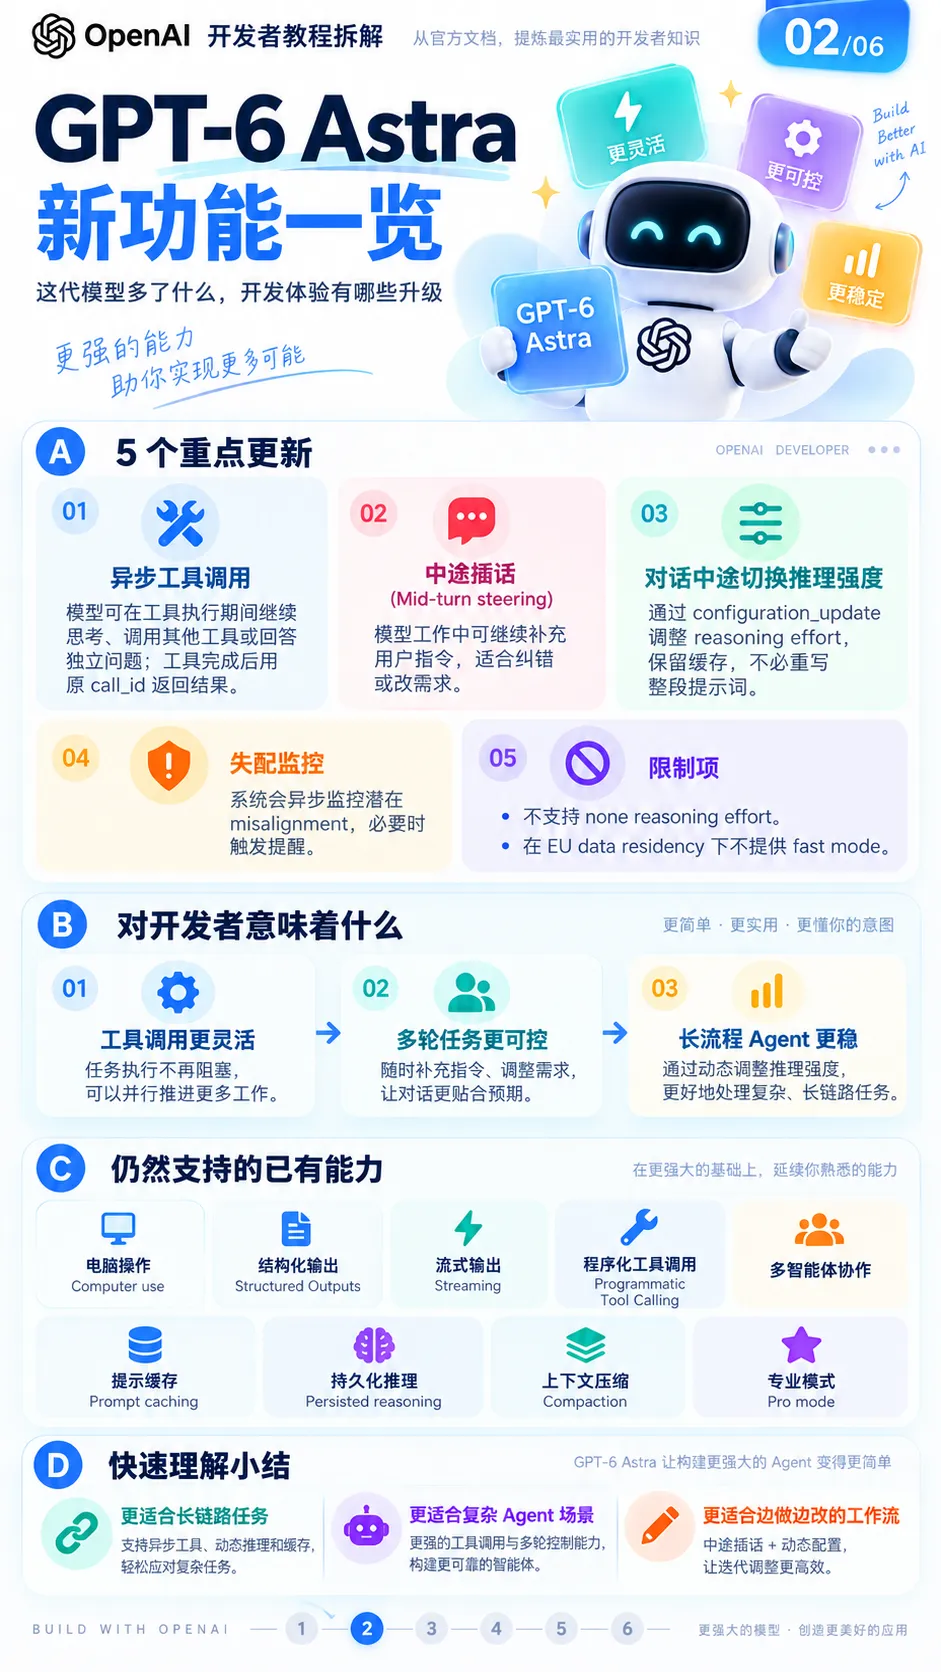
Astra 天生喜欢洋洋洒洒列出一堆 Markdown 表格、繁复的清单,还很爱说漂亮话。
官方在文档里明确建议用户限制它使用空洞修辞。
直接给了现成的提示词,让它默认用清晰简洁的段落、只在信息真的平行或有顺序时才用列表、避免嵌套列表。
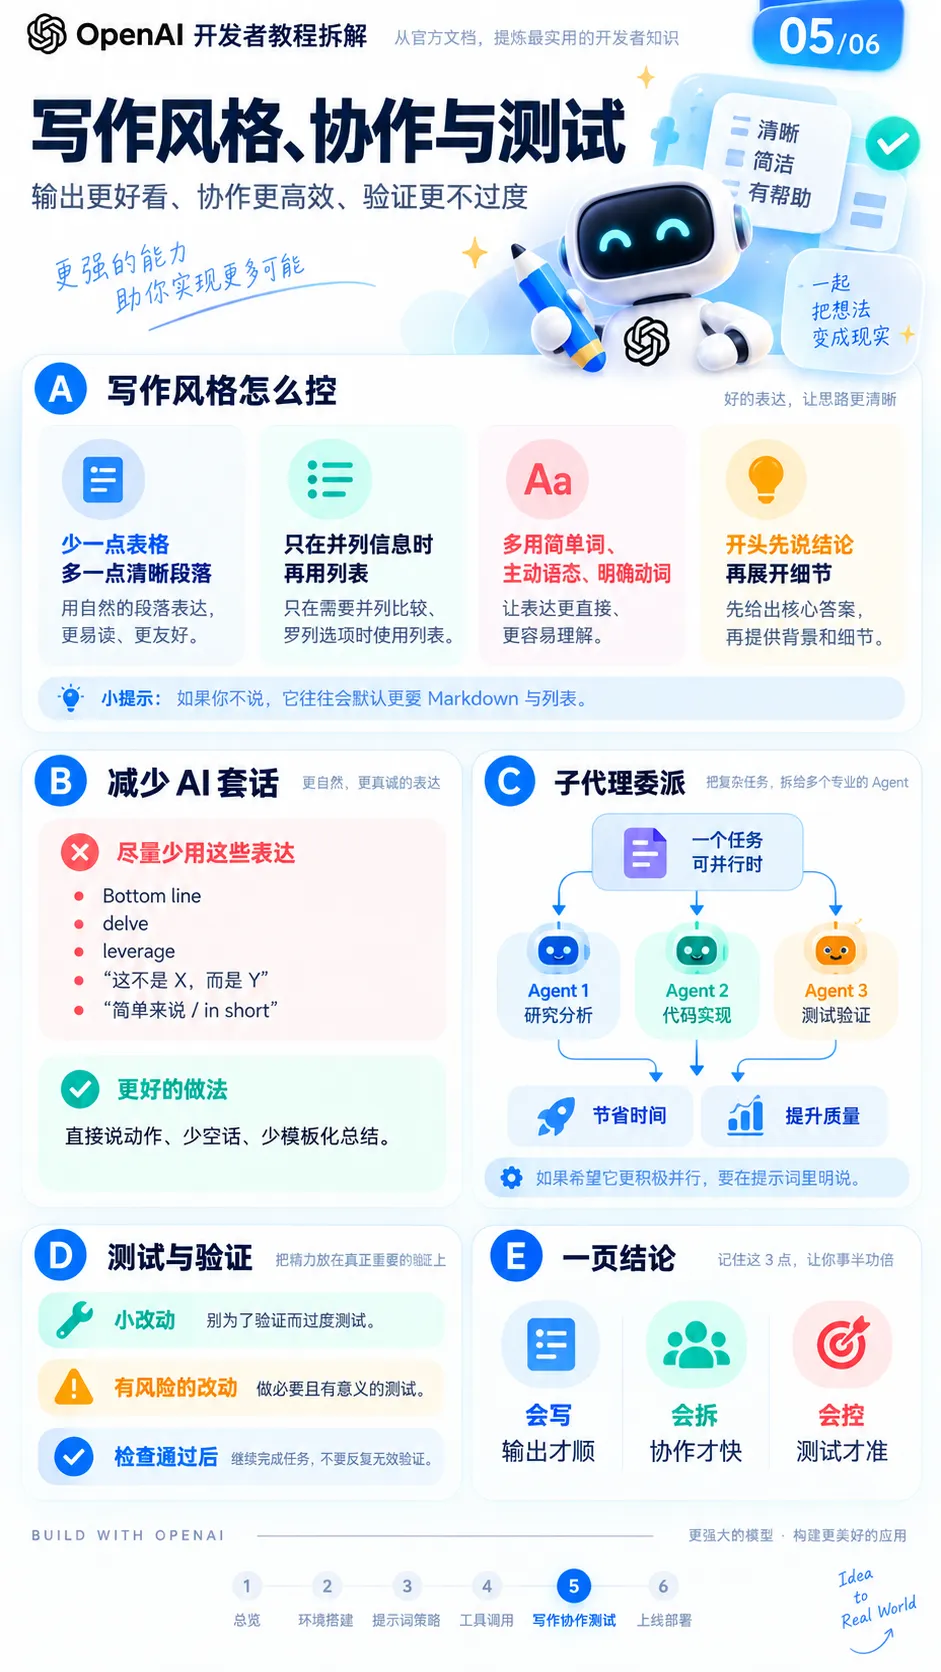
所以在提问时加上一条约束:
Avoid using slop words or phrases like "Bottom Line:" in conclusions, "delve," "foster," "leverage," "it's worth noting," "importantly," "Question? Answer." or "This isn't about X. It's about Y.", "genuinely" or hyphenated compound descriptions and adjectives. Do not use concluding summary statements such as "In short:..", "The simplest mental model is:...".

State the intended action directly. Avoid adding what you won't do, what will remain unchanged, or how you'll separate or categorize results. Do not use contrastive framing such as "X, not Y" or "X—not Y" that introduces an unprompted alternative that the user didn't ask about. Avoid invented compound labels like "exact-head checks" and "editorial-row layouts", vague qualifiers, and canned transitions; use plain verbs and prepositions to state the actual relationship directly.
仅仅是去掉这些无意义的格式填充,就能把输出 token 砍掉一大截。
指南里甚至列了一串黑名单词。
比如 "Bottom Line:"、"delve"、"leverage"、"it's worth noting"、"In short:",以及 "X, not Y" 这种对比句式。
是不是很眼熟?
这就是我们非常熟悉的“不是.....而是.....”、“总得来说”、“这意味着”这些AI味的词语。
对中文写作者来说,这份黑名单本身就值一篇文章。
AI味的根源,OpenAI 自己已经归纳好了。
今天的干货时间,就再给大家推荐@大头阿丽的这篇“AI积分别白白浪费!5个AI省Token实用技巧”。
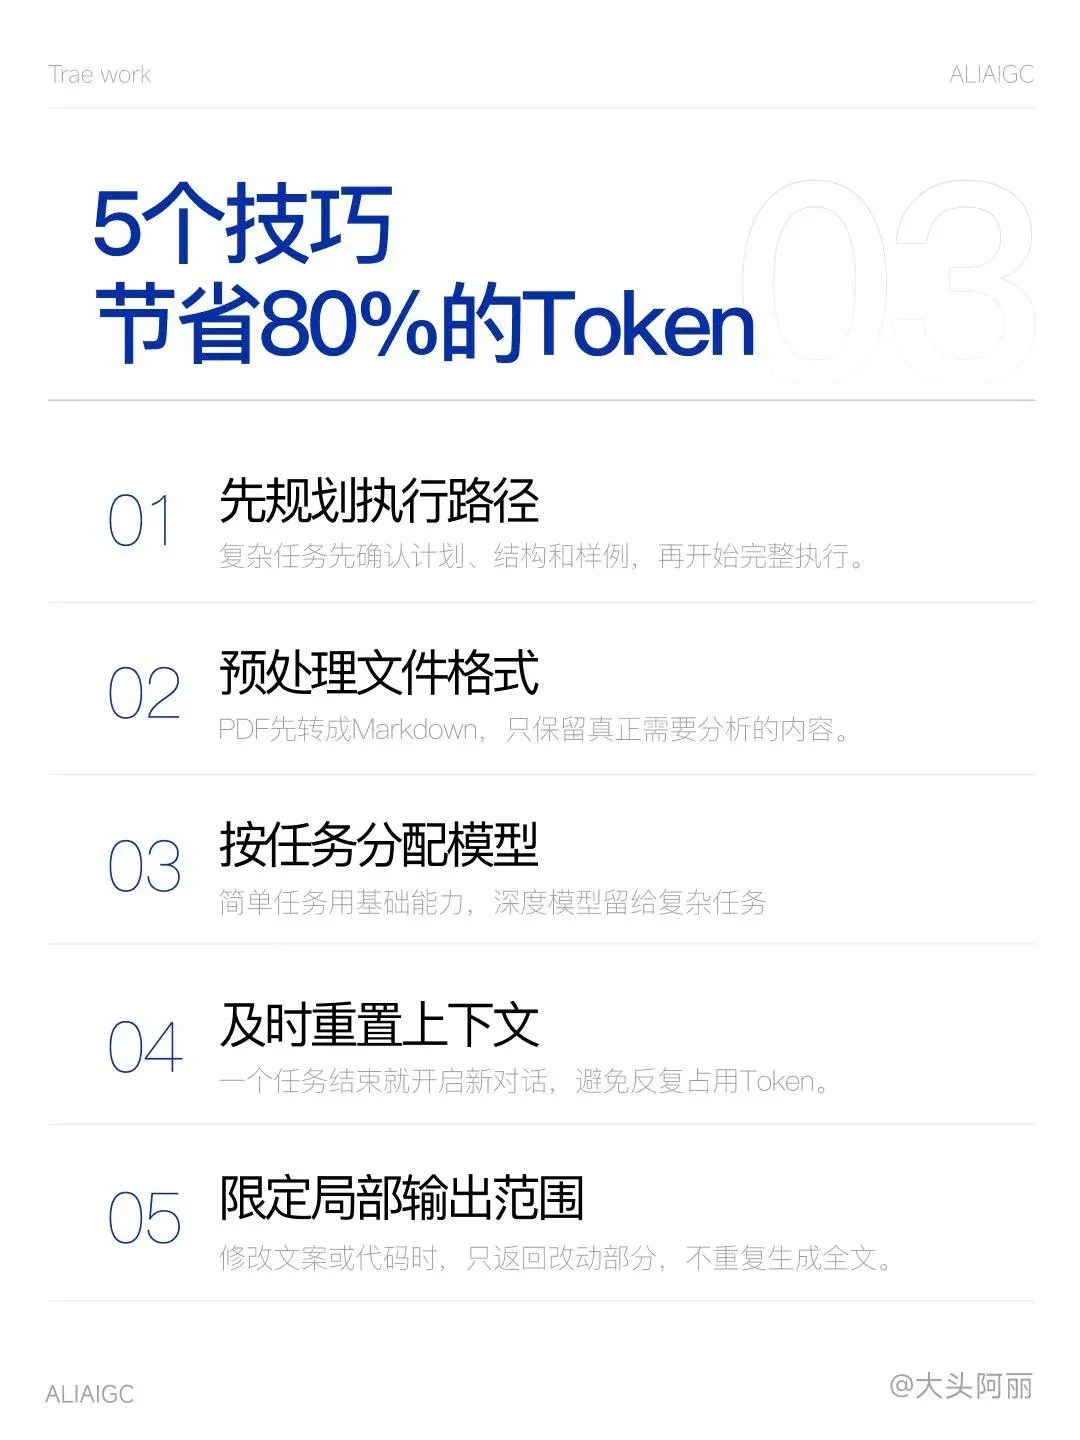
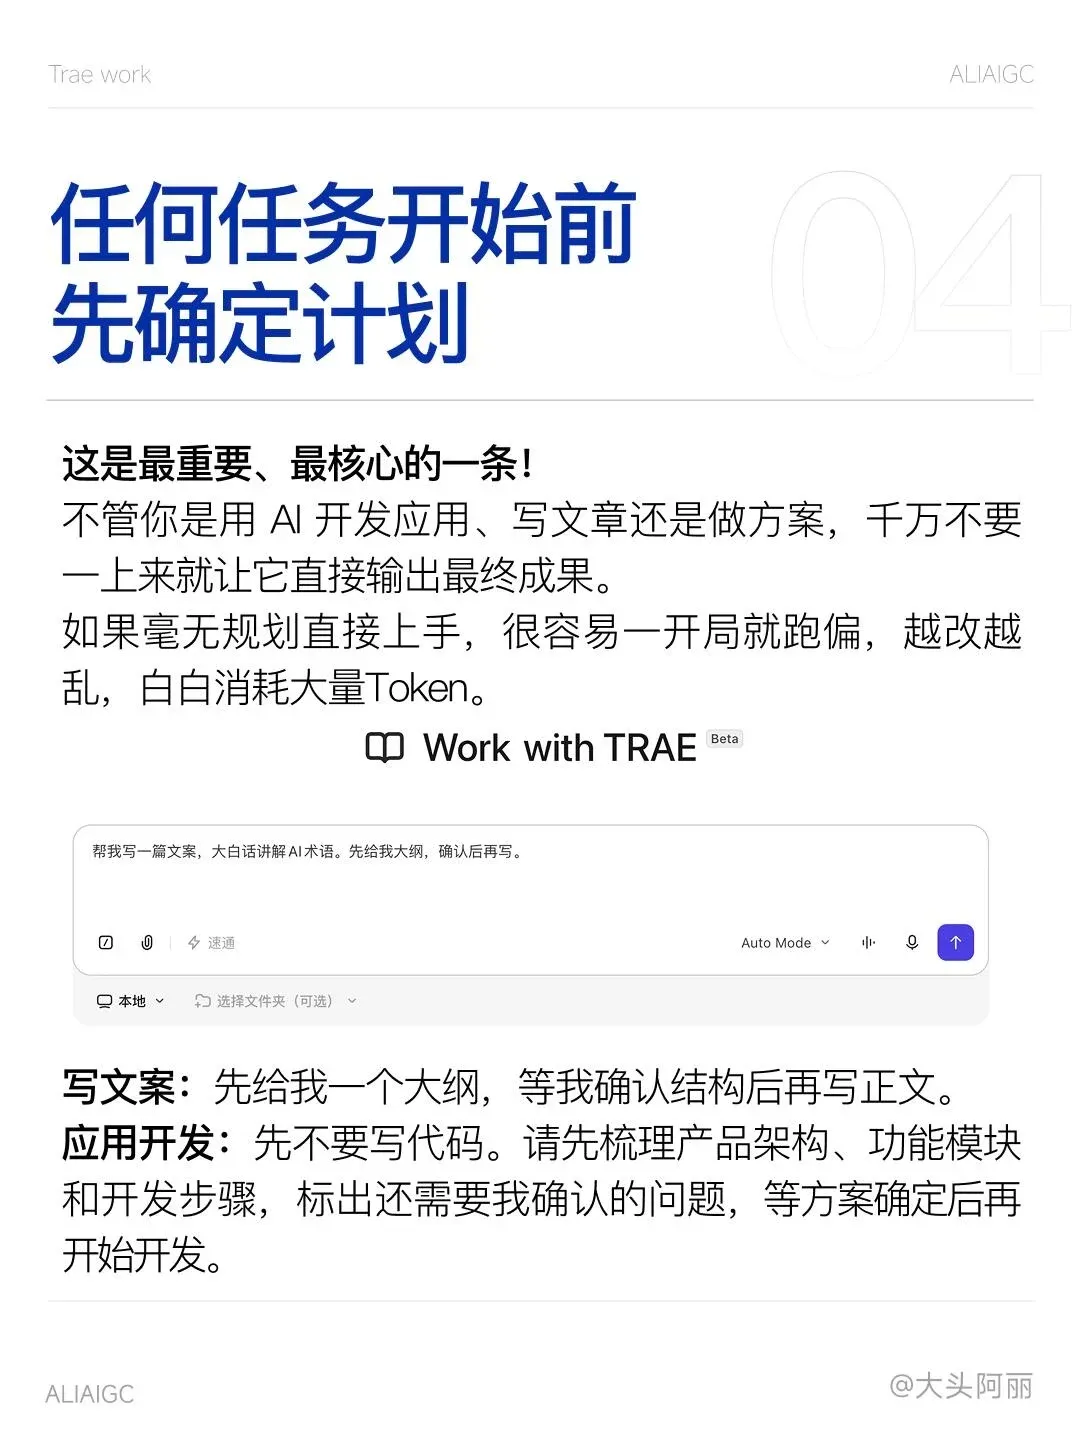
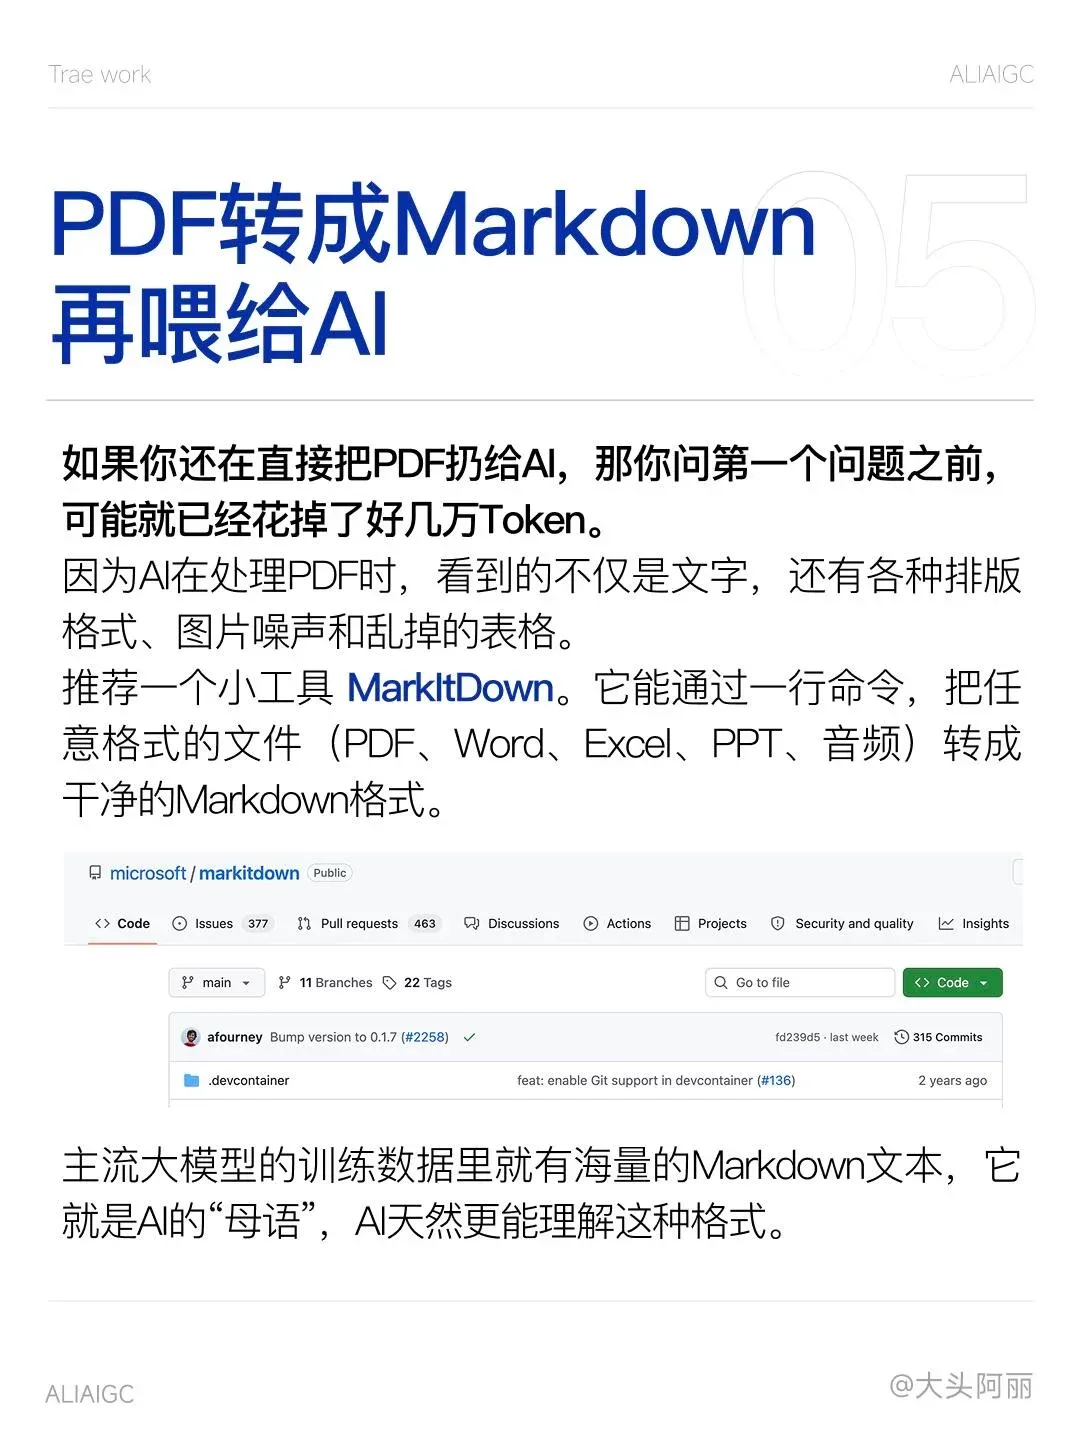
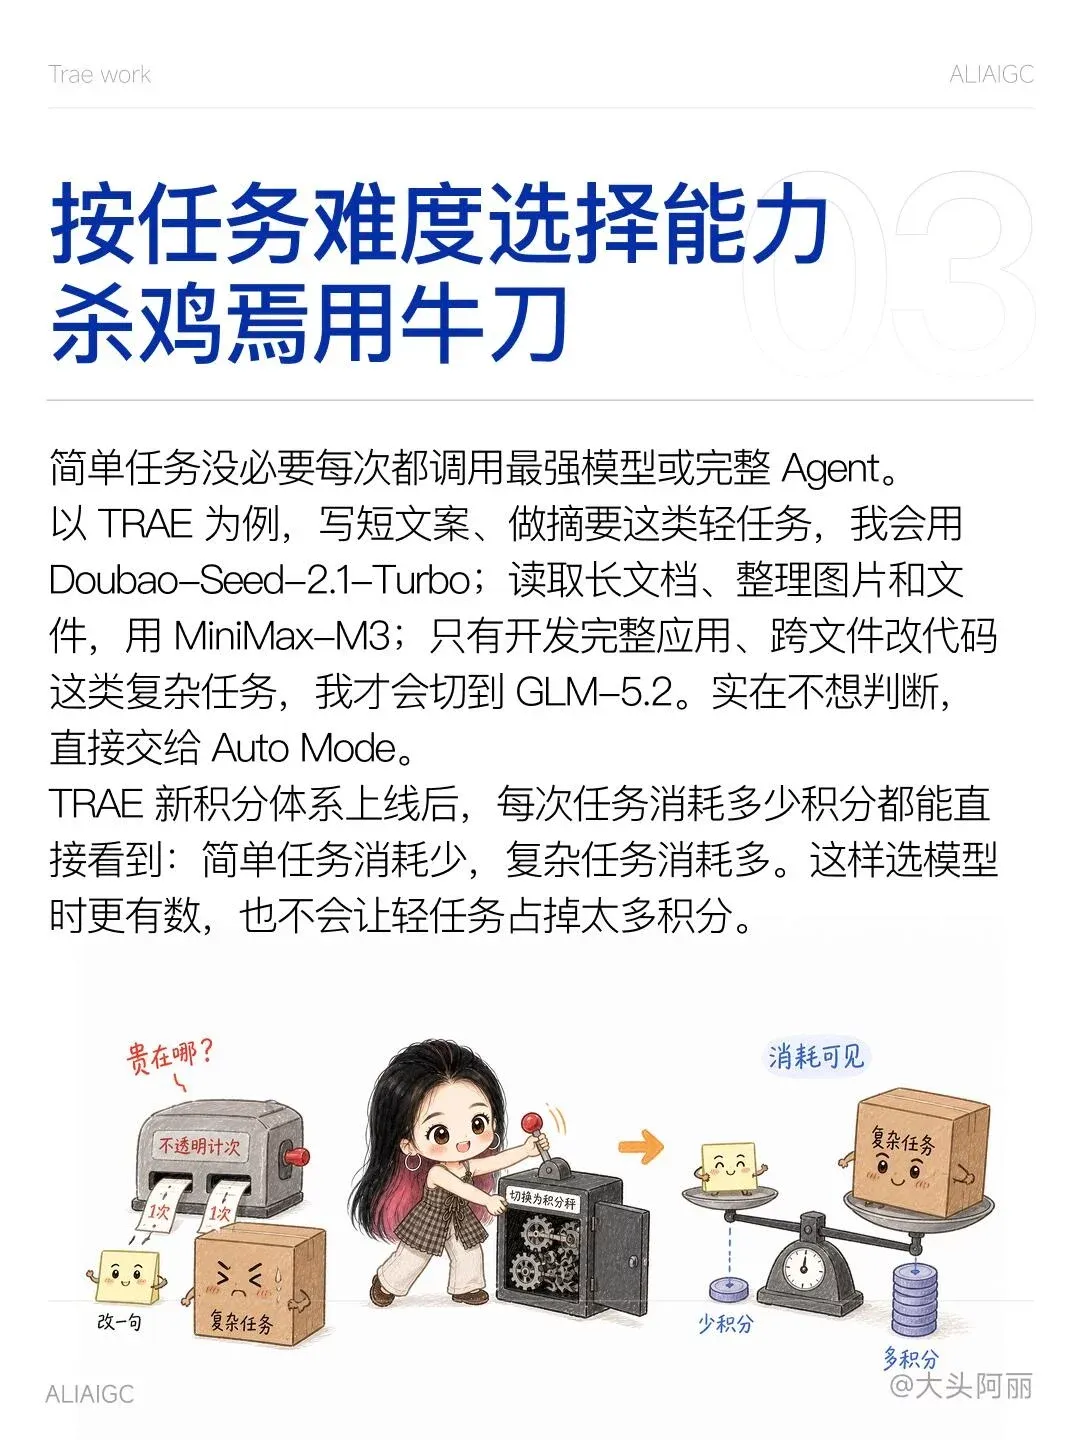
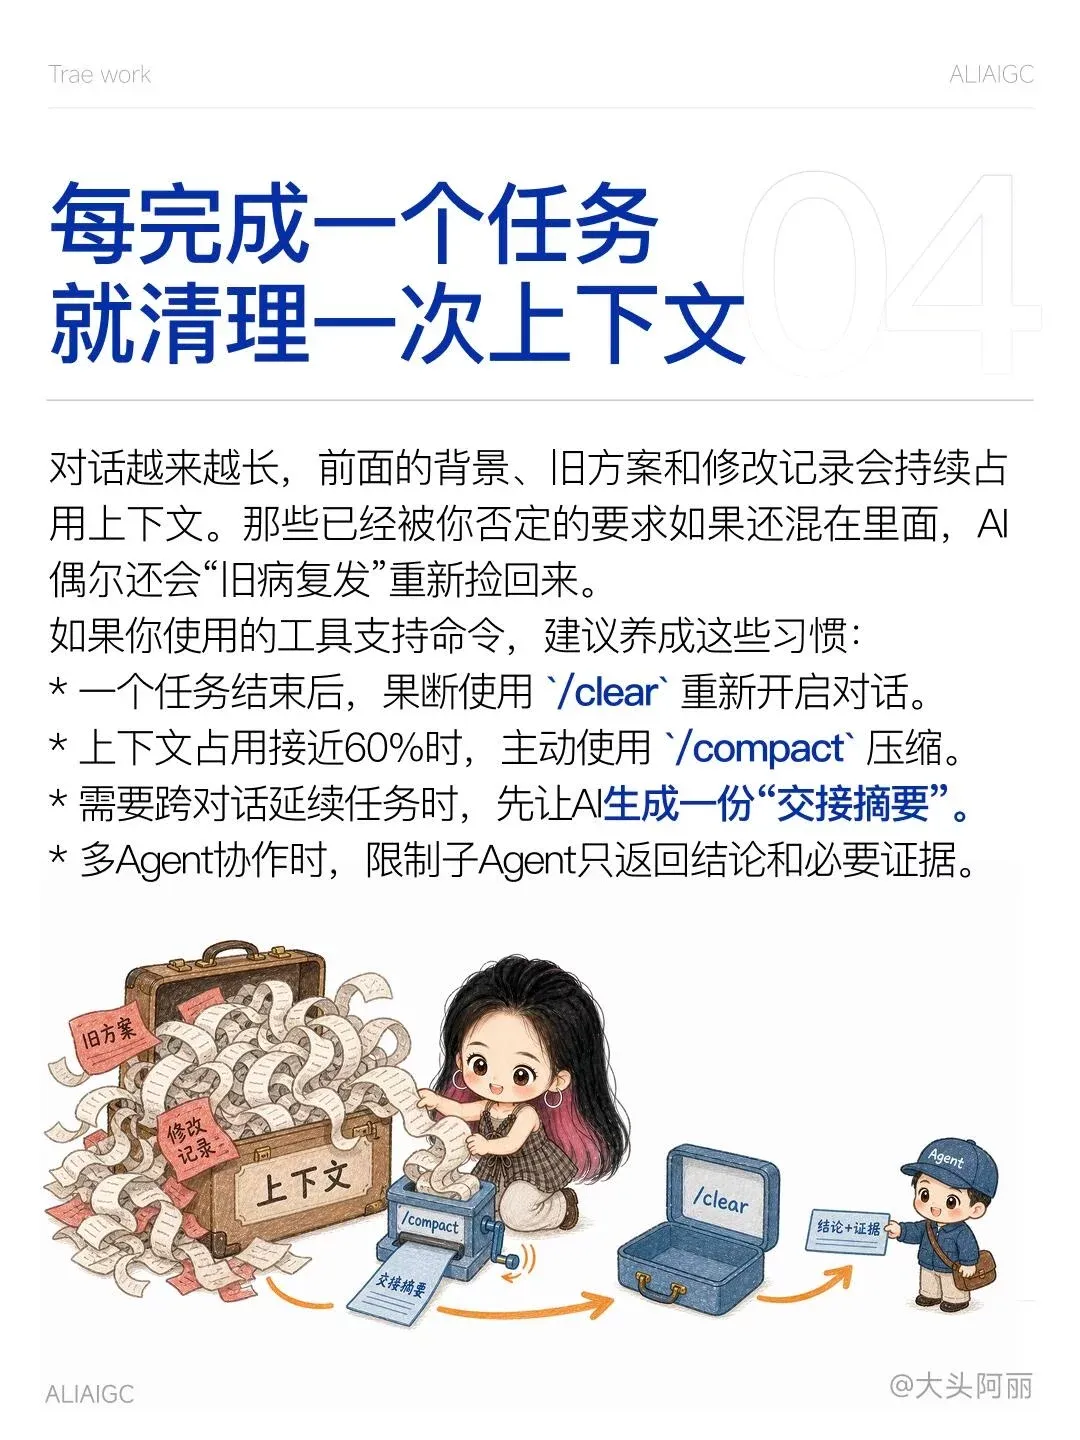
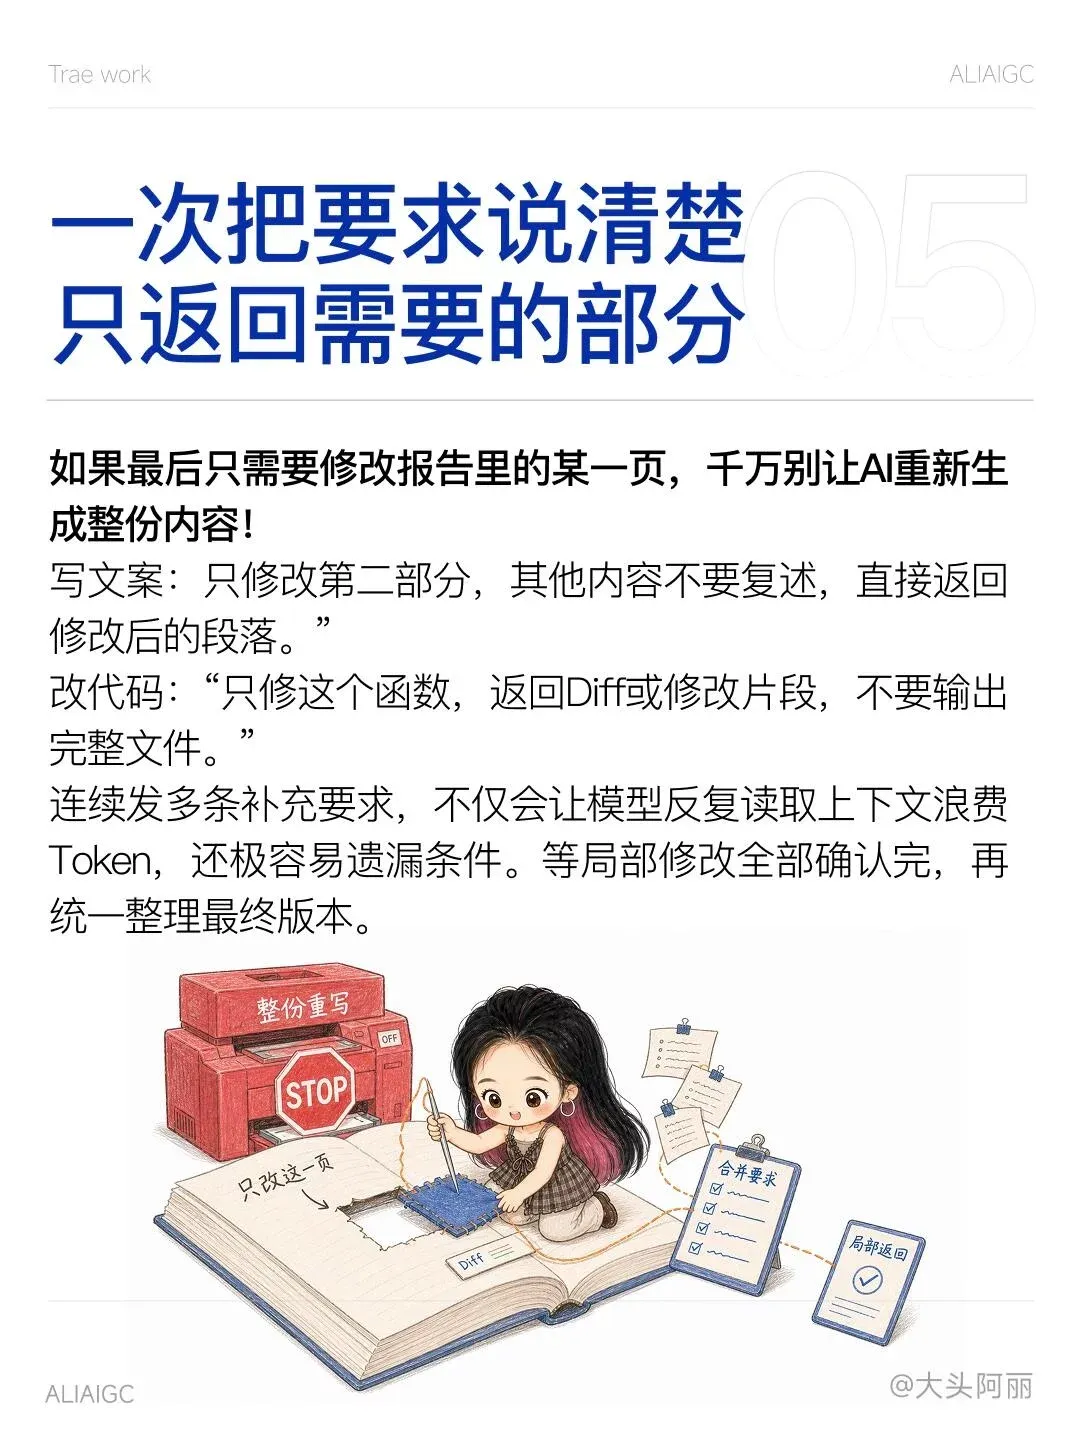
里面有作者从自己工作中总结出来的省Token方法,可以和OpenAI官方指南互为补充。
复制本文链接 文章为作者独立观点不代表优设网立场,未经允许不得转载。
彭彭
90.5w人气 22文章
发评论!每天赢奖品
点击 登录 后,在评论区留言,系统会随机派送奖品
2012年成立至今,是国内备受欢迎的设计师平台,提供奖品赞助 联系我们
用户体验增长
已累计诞生 795 位幸运星
发表评论
↓ 下方为您推荐了一些精彩有趣的文章热评 ↓