
等了半个多月,GPT-6.2,终于来了。
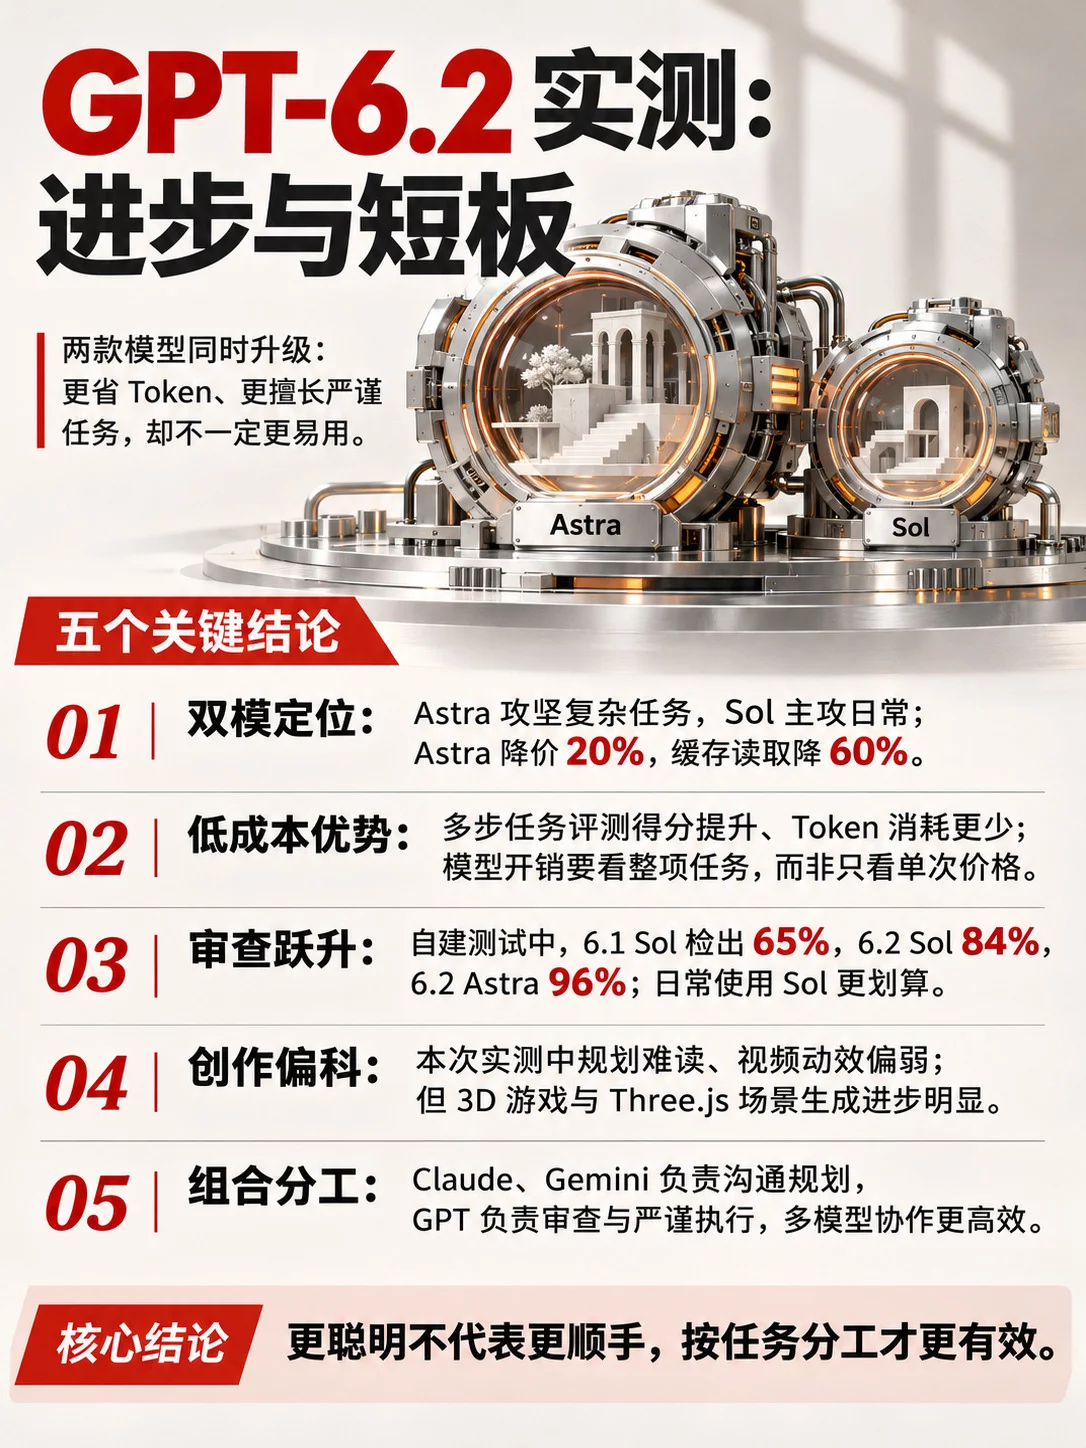
这次是 GPT-6.2 Astra 和 Sol 一起发,一个旗舰,一个日常主力。
这个模型真的拖得太久太久了。
从 11 月 1 号前后,就有人说灰测到了 GPT-6.2 Sol,我后来也灰测到了升级的版本,结果这一等,就等了将近 20 天。
今天,终于发了,ChatGPT、Codex 还有 API 已经全部同步上线了。
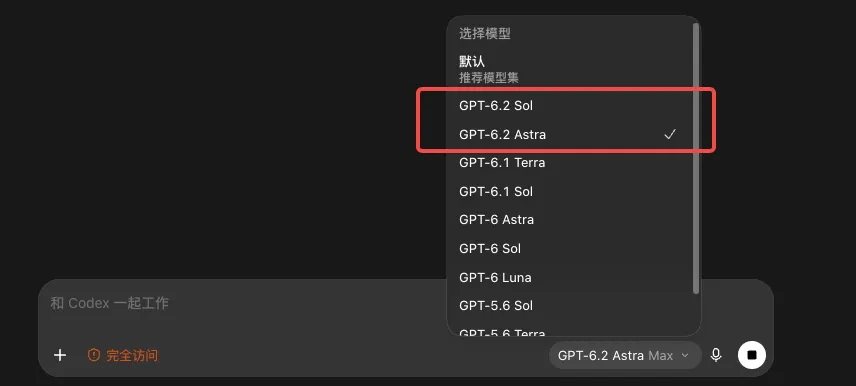
官方的一些信息读完了,然后我自己也跑了很多测试。
就怎么说呢,这是一个让我有一点失望的模型,它有它特定的作用而且极其偏科,但是对于我来说,可能确实很难有质的体验的飞跃。
那一个一个说吧。
老规矩,开头我们惯例先把基本信息过一下。
这次是两个模型。
GPT-6.2 Astra,官方定位是给你最难的项目用的前沿模型,API 里的编号是 gpt-6.2-astra。
GPT-6.2 Sol,官方定位是日常工作用的高效模型,API 里的编号是 gpt-6.2-sol。
知识截止日期这次有更新。
GPT-6.2 Astra 是 2026 年 5 月 18 日,GPT-6.2 Sol 是 2026 年 6 月 1 日,不过因为后训练的原因,所以实际了解的知识,会比这些日期更往后延一些。
GPT-6 Astra 当时是 4 月 30 日,这次往后推了半个月到一个月,我们当时测是否被灰度到新模型的时候,其实就是看的知识库日期,就是问 “禁止联网,你知道 Fable 5” 吗,就可以看出来是 GPT-6.1 还是灰度到 GPT-6.2 了。
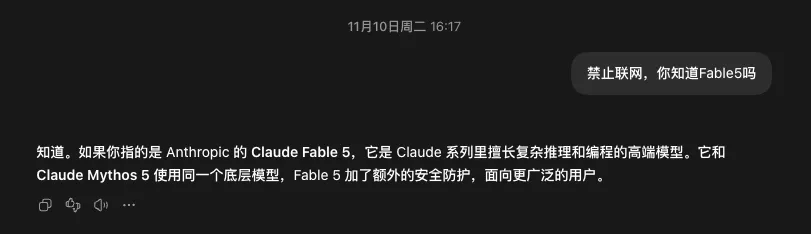
因为 GPT-6 Astra 和 GPT-6.1 Sol 其实都是不知道 Fable 5 这个模型的。
然后价格上,Astra 降价了 20%,每百万输入 Token 8 美元,输出 40 美元,缓存读取从 1 美元直接降到 0.4 美元,缓存这块降了 60%。
Sol 不变,还是输入 2 美元,输出 10 美元,缓存 0.1 美元。
大家还记得我上周写 Fable 5.2 的时候说过吗,Fable 5.2 降价以后的价格,是输入 8 美元,输出 40 美元,这次 GPT-6.2 Astra 一模一样。
上一次 GPT-6 Astra 发布的时候,定价是跟 Fable 5 对齐的,这次 Fable 5.2 降了,OpenAI 又跟着对齐了,但还是有个问题,就是大家都知道,你前面两个定价不重要,最重要的是缓存读取的价格以及完成任务需要的 Token 数。
价格上,我简单做了一个表。
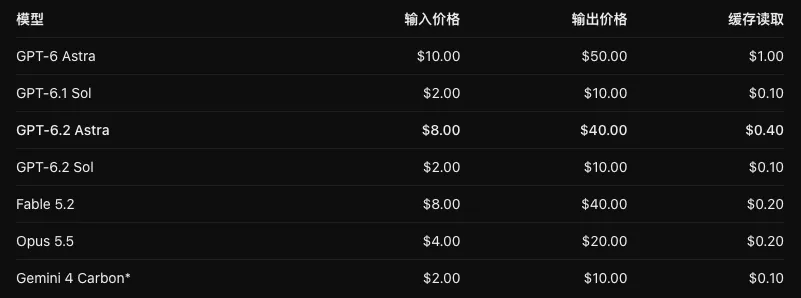
之前 GPT-6 Astra 的缓存读取贵到没边了,整整 1 美刀啊,所以大家为啥说烧得那么快,这次确实大幅降价了,降到了 0.4 美刀,相比之下,Fable 5.2 是 0.2 美刀,Gemini 4 Carbon 现在限时半价只要 0.1 美刀。
但至少确实是比以前便宜多了,不再是直接爆表了,我还记得 GPT-6 Astra 刚出的时候,我一天就能用完一个 200 刀的 Pro 账号的额度……
但除了价格之外,还有个东西就是完成任务的 Token 数,这也是一个必须要看的衡量指标,所以虽然你会看到 GPT-6.2 Astra 在定价上好像是要比 Claude Fable 5.2 要贵,但如果你去真的使用这两个模型的话,你会感觉到 Claude Fable 5.2 消耗额度消耗得极其恐怖,就是因为,完成任务所需要的 Token 数差距太大了。
这个我们在第二趴详聊。
这一次,OpenAI 依然延续老传统,因为确实在模型的智力和能力上打不过 Claude,所以整个模型的关键词,以及所有官方图表的横轴,都是一个东西。
每个任务花多少钱。
比如这个 Agents' Last Exam,这是一个测多步骤专业工作的评测,你可以理解成给 Agent 的期末考。
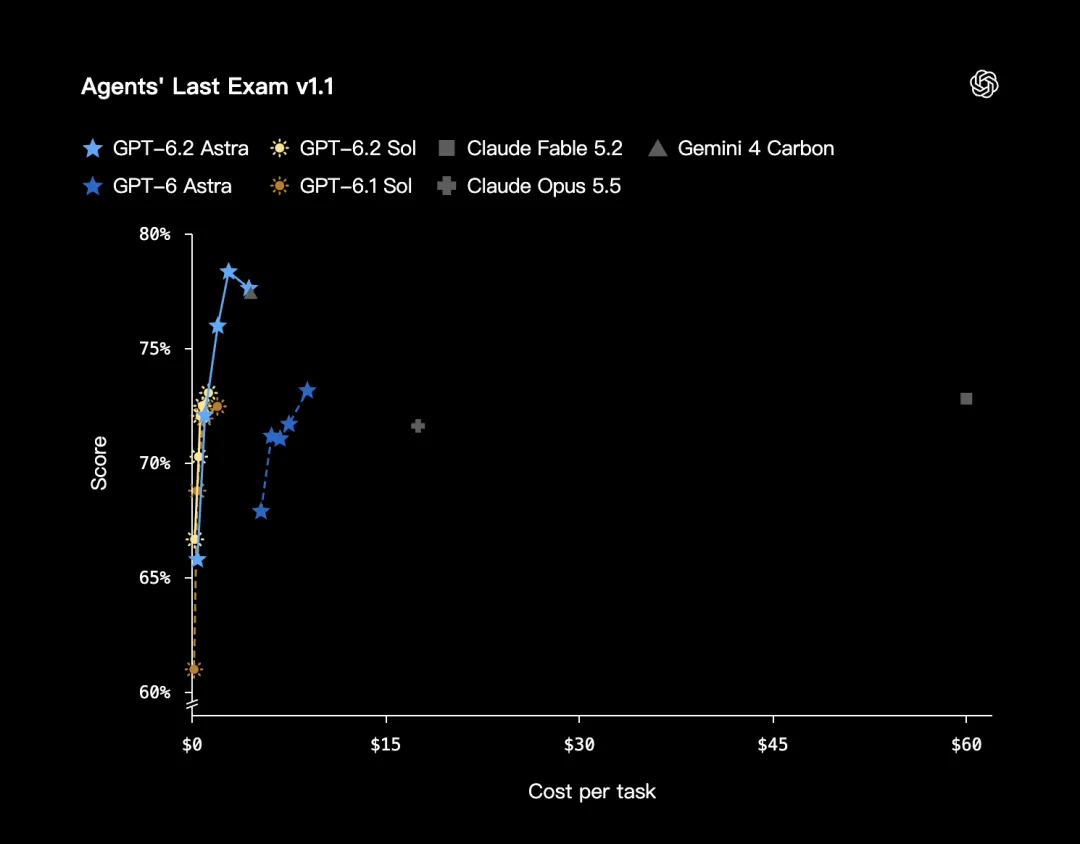
GPT-6.2 Astra 大概是 78%,每个任务约 3 美元。
Claude Fable 5.2 大概是 73%,每个任务约 60 美元。
分数高了 5.5 分,成本只有对方的 5%。
而跟自家的上一代 GPT-6 Astra 比,分数高了 5.2 分,成本不到三分之一。
明明 Claude Fable 5.2 价格不是比 GPT-6.2 Astra 便宜吗,为啥最终差距能有这么多呢,秘诀就在于消耗的 Token 量。
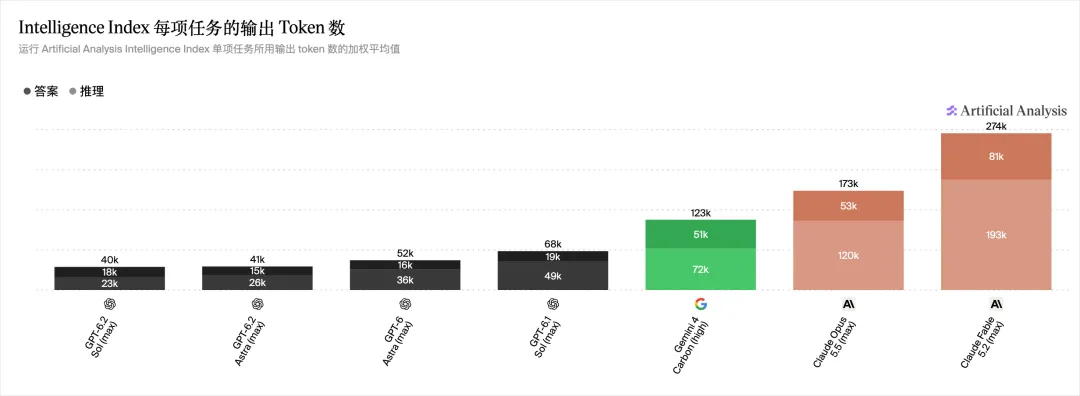
从这个每项任务的输出Token量来看,GPT其实是非常恐怖的,Token消耗极少,而Claude为了追求更高的能力上限,会疯狂地投入推理资源,所以在每任务的Token输出上,甚至能差到7倍。
这也解释了,为啥明明纸面价格上,Claude Fable 5.2 是要比 GPT-6.2 Astra 便宜的,但是 Claude Fable 5.2 却基本上是我们烧不起的程度,而 GPT-6.2 Astra,在实际的 Token 的消耗上,反而就要好一点。
比如我是 200 刀的 Pro 会员,跑了大概 4 个视频和 3D 的 Case,还跑了 2 个大方案的规划,以及近百个代码的审查,跑之前我的周额度剩余 12%,这些跑完我还剩 6%,也就是消耗了 6% 的周额度。
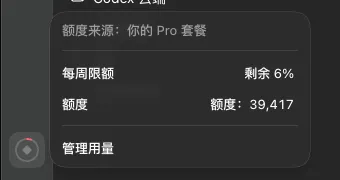
而上次 Claude Fable 5.2,10 个 Case,烧完了我近 30% 的周额度,虽然效果远超 GPT,但是也能看出来这个经济差异。
在官方 blog 里,其他的任务也是类似的,比如 Terminal-Bench-Science,测的是模型在终端里做科研任务的能力,这个就是 GPT 的拿手好戏了,我绝大多数的做科研的朋友给我的反馈都是,GPT 几乎就是他们的科研主力模型,在做科研层面,GPT 是一骑绝尘的。
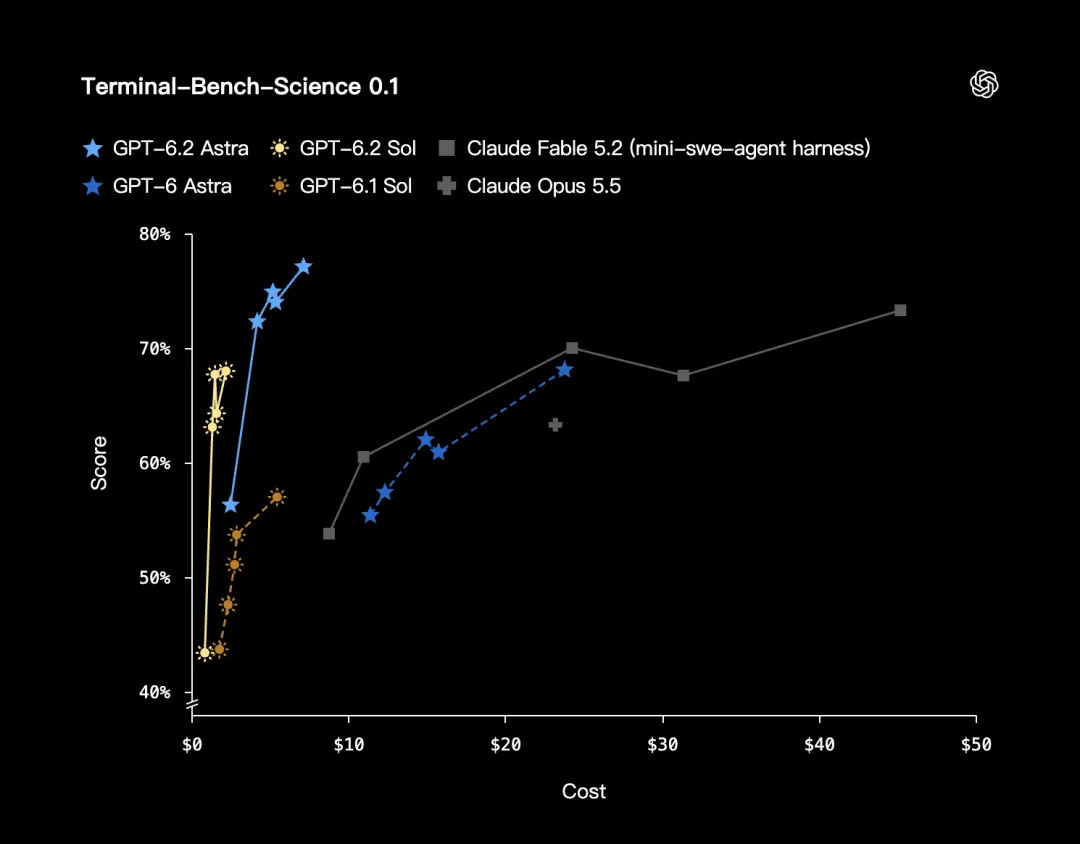
而在这个任务里,GPT-6.2 Astra 大概是 77%,每个任务约 7 美元,上一代 GPT-6 Astra 是 68%,却要花 24 美元左右。
OpenAI 也因此把 Astra 称为世界上最适合科学家的模型,第三方的 Vals 科学指数,它也确实是第一。
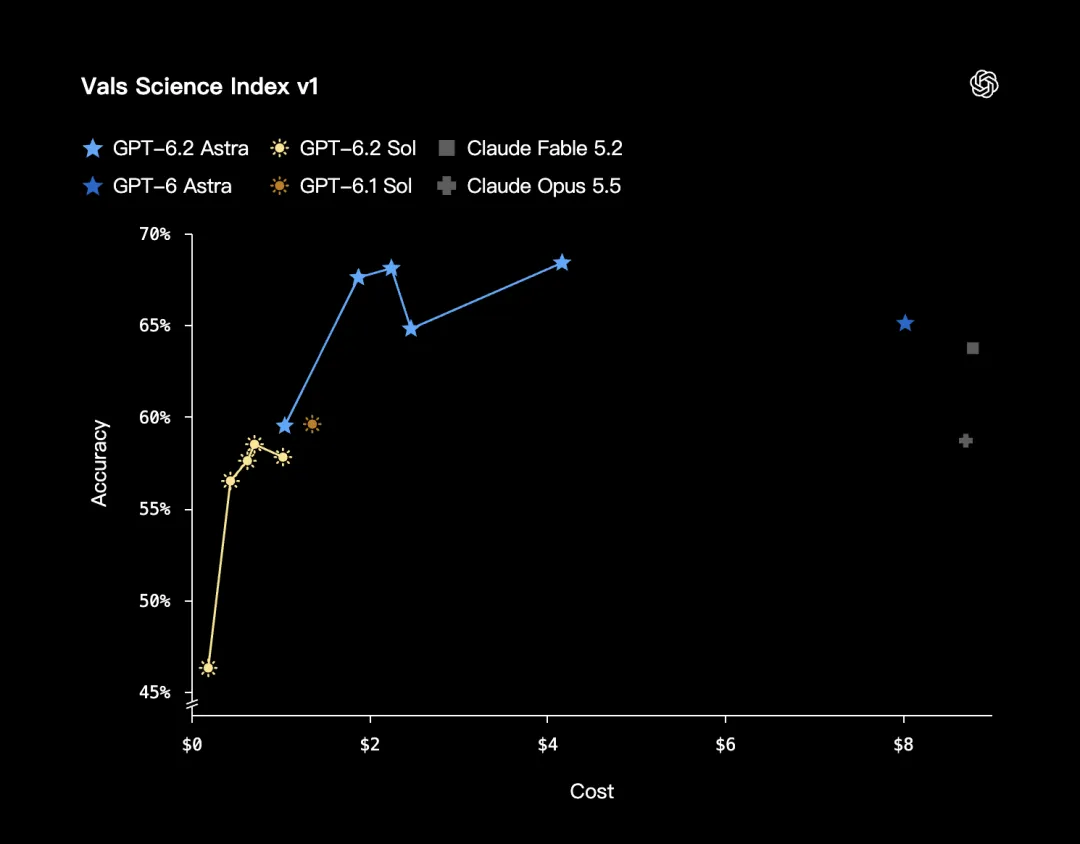
第三个是 OpenAI 内部的 GDPval v2,测的是咨询、金融、设计这些真实行业里的长程知识工作,结论也差不多。
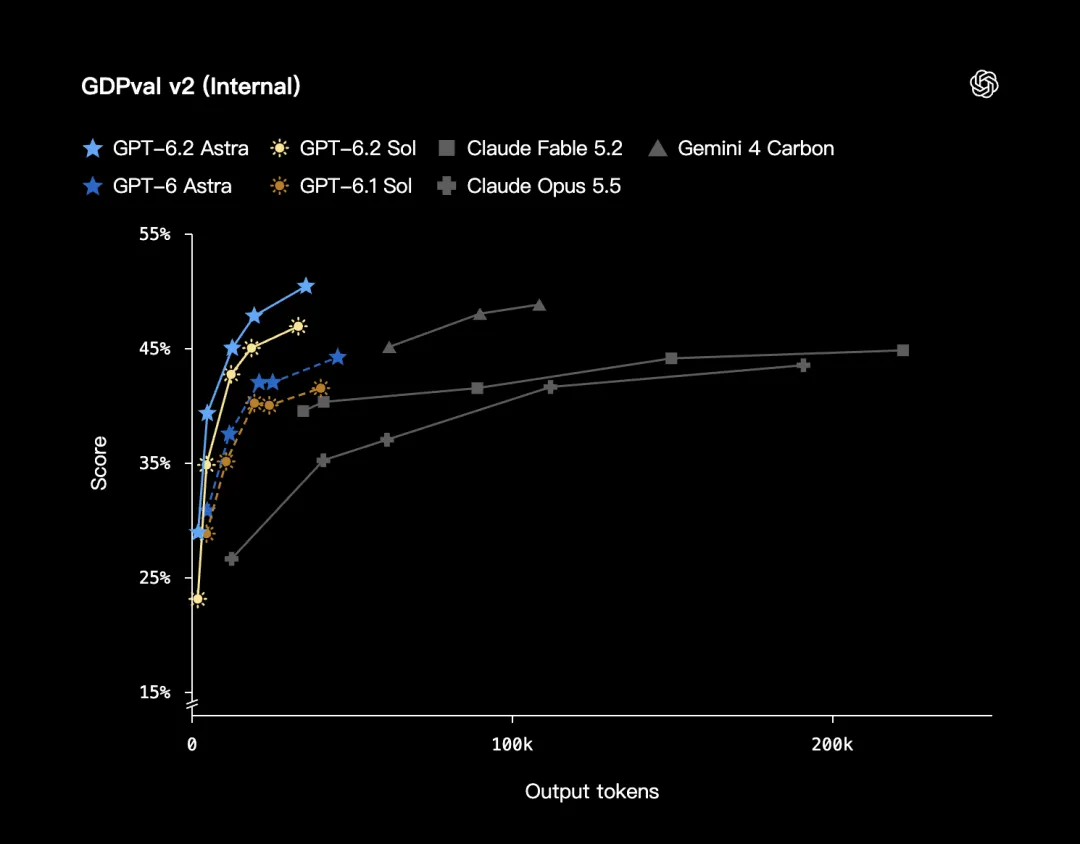
主打的就是一个省钱。
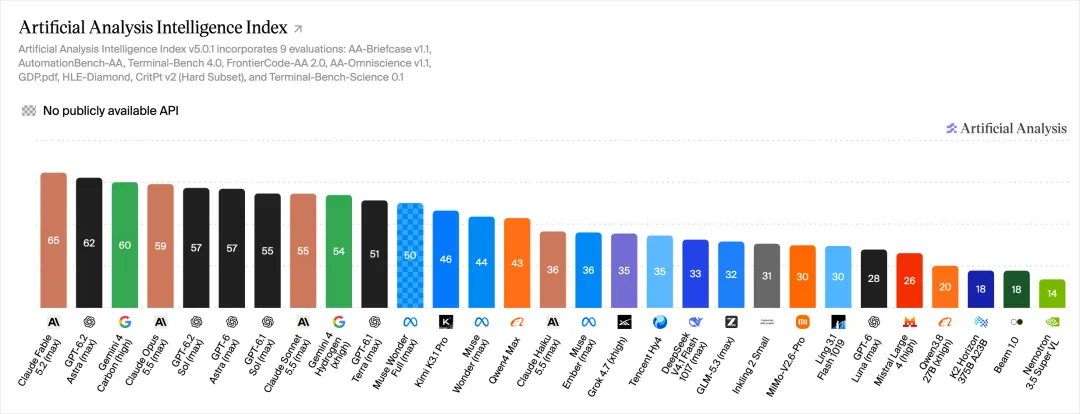
AA 的智能指数上,这一次进步还是明显的,GPT-6.2 Astra 相比之前,涨了 6 分,拿到了 62 分,回到了第二的位置,GPT-6.2 Sol 涨得不多,只涨了 2 分。
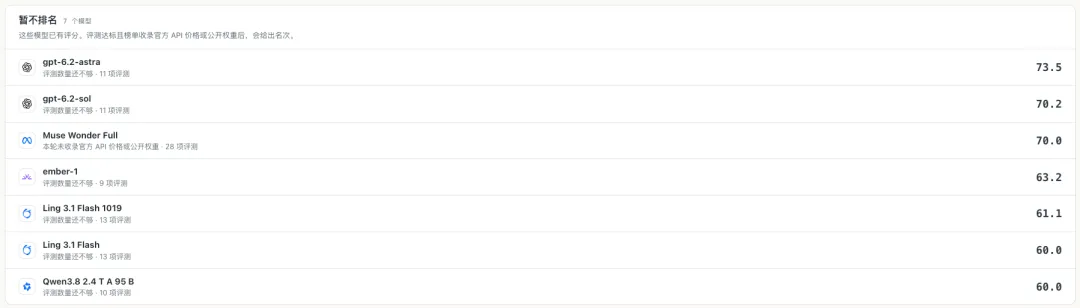
过大概1天,AIHOT的模型榜也应该就会对GPT-6.2系列的两个模型开分了,到时候大家也可以看看排名情况,然后这里也可以简单说一下,很多时候第一天没分是因为给模型评测的机构不够,他们没开分,所以已出分的数据源还不到一半,放在了最下面暂不参与评分里,因为我们整体是ELO的策略,数据太少的话不是很准,变动会比较大。
接下来,我也做了一些详细的测试。
首先,我自己最关心的,模型的沟通能力和方案规划能力,这个在过去一直是GPT模型系列的短板,GPT模型我自己的定位一直是一个极其严谨、干活细致、绝不出错的模型,在后端、科研、审查层面其实能力是极强的,但是在传统的项目方案规划(非科研)和可读性上,其实是比较差劲的。
那正好就有这么一个任务,最近其实很多朋友都希望我在AIHOT的每一条新闻下面,加一个留言区,他们希望可以交流。
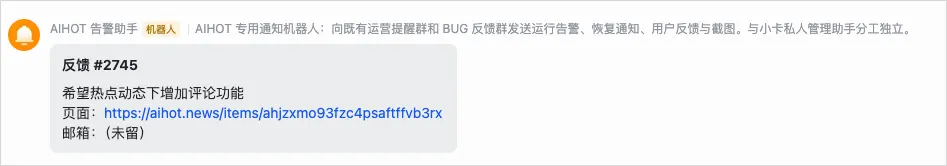
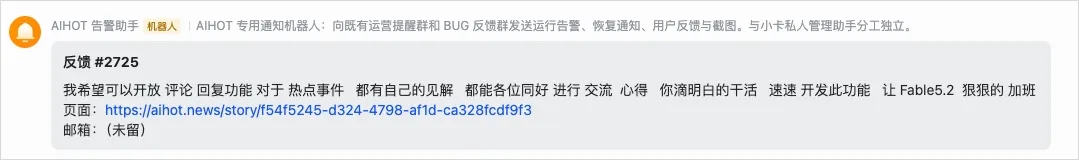
这个事情其实远远不是加个留言功能这事这么简单,如果只是可以回帖评论啥的,那就太简单了,麻烦的是,国内的合规问题和审查。
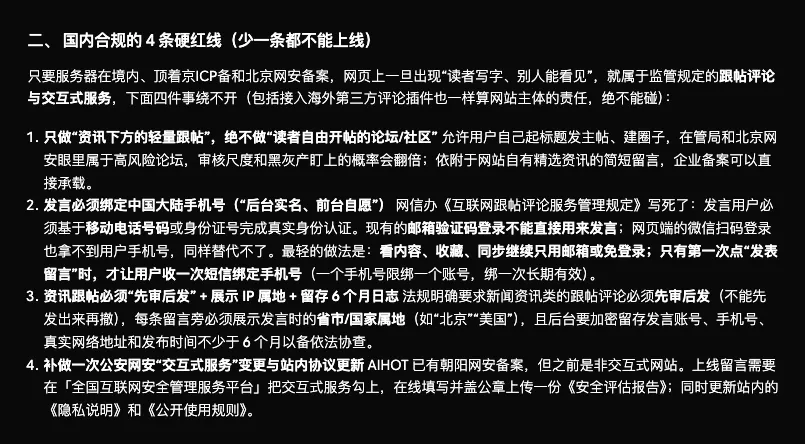
比如如果要加交流功能,那就必须加实名制,也就是必须要有手机号登录功能,而手机号登录的验证码是很贵的,并且最麻烦的是,你要有审查,必须要先审后发,那还需要加审查机制等等等等。
因为AIHOT就是我日常自己闲暇时间维护的一个纯个人项目,所以这个功能,大家提了2个月了,我其实都一直在纠结,它对于我的成本还有风险,都会大幅上升。
但是它不影响测试,那现在假设我们现在就要做这个事了,到底应该怎么做比较好,我让模型来给我建议,这时候就能看出模型的规划和方案可读性的问题了。
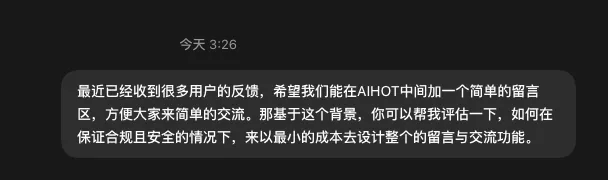
我的Prompt特别简单,甚至都不能称为是一个Prompt。
“最近已经收到很多用户的反馈,希望我们能在AIHOT中间加一个简单的留言区,方便大家来简单的交流。那基于这个背景,你可以帮我评估一下,如何在保证合规且安全的情况下,来以最小的成本去设计整个的留言与交流功能。”
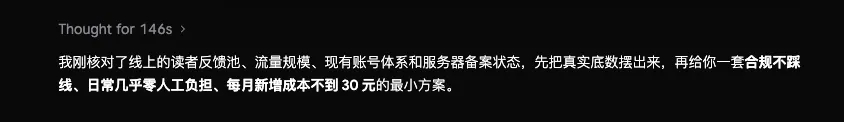
在给大家看GPT-6.2 Astra的方案之前,我先给大家看一下,Gemini 4 Carbon给我的方案规划(我最近很喜欢用这个模型+Claude一起出方案然后合并,Gemini 4 Carbon这个模型真的很特别)。
这个方案,大概花了5分钟。
第一句话,其实就非常理解我的需求。
然后,给我列出了必须要遵守的合规项,这个跟我了解到的其实是完全一致的。
然后给了我一份最小成本的设计方案,非常棒,而且细节很多,比如不开放自定义昵称,不做多层盖楼,不开全量只开精选等等,然后在先审后发这块,复用我们如今已经做好的Agent全自动的新闻审查机制。
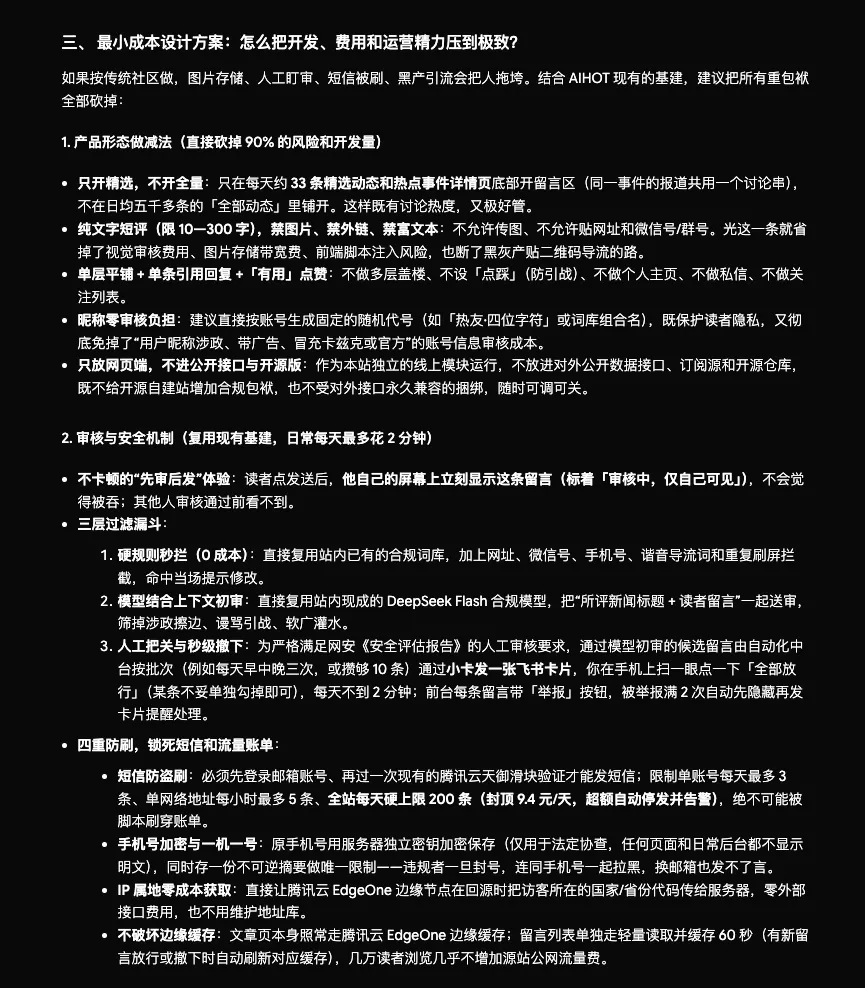
最后,给我对比,以及问我选择。
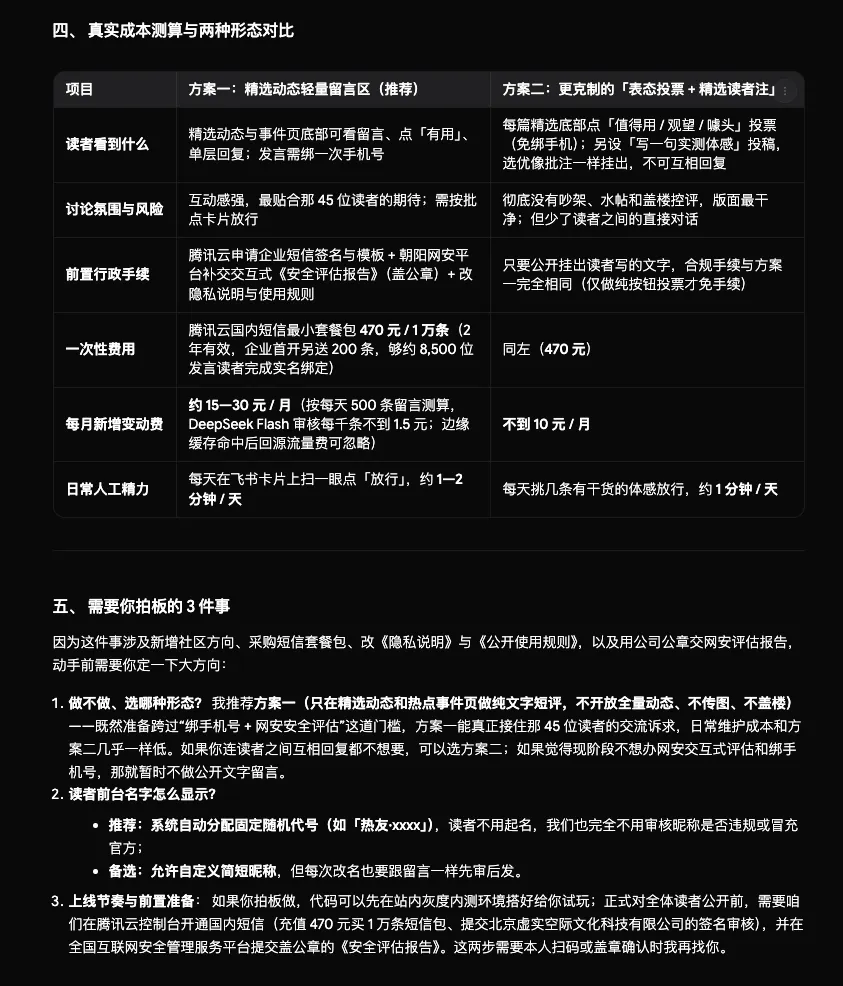
干干净净,极其清晰,并且有很多启发,中间可能会有部分幻觉,还需要Claude再审一道,但是整体已经非常不错了,主要是可读性也极强,我能看得下去,有极强的实操性。
好,看完了Gemini 4 Carbon的,我们再回来看GPT-6.2 Astra的。
一共跑了24分钟,是Gemini 4 Carbon的近5倍,然后这是回复,上面还有几行基础的公司信息我就不放了,也没有很大的意义,核心就是这一屏。
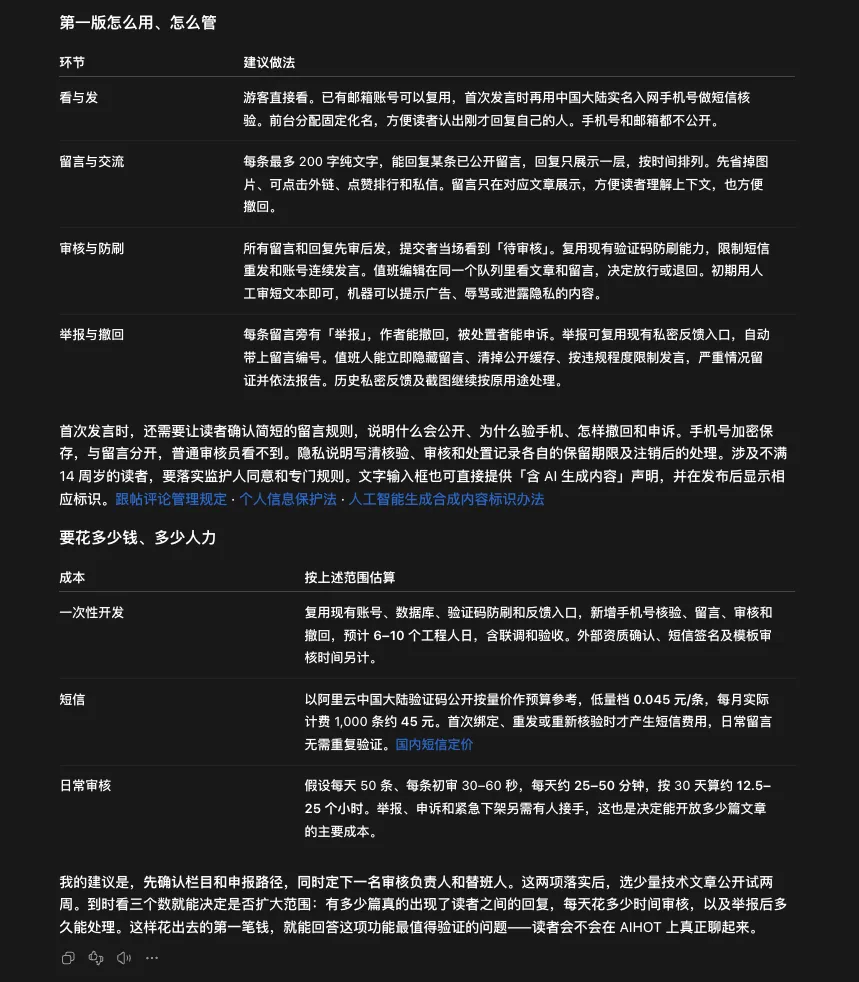
坦率地讲,我不知道大家读这个回复的感受怎么样,明明很短,但是我就是读得云里雾里,看完了以后的感觉也是如看,可读性极差,并且里面居然说前期建议是人工审核,我是疯了吗我,我每天无时无刻蹲在屏幕前来审大家的评论?这是人能给出来的建议?
排行榜的方案规划也是。
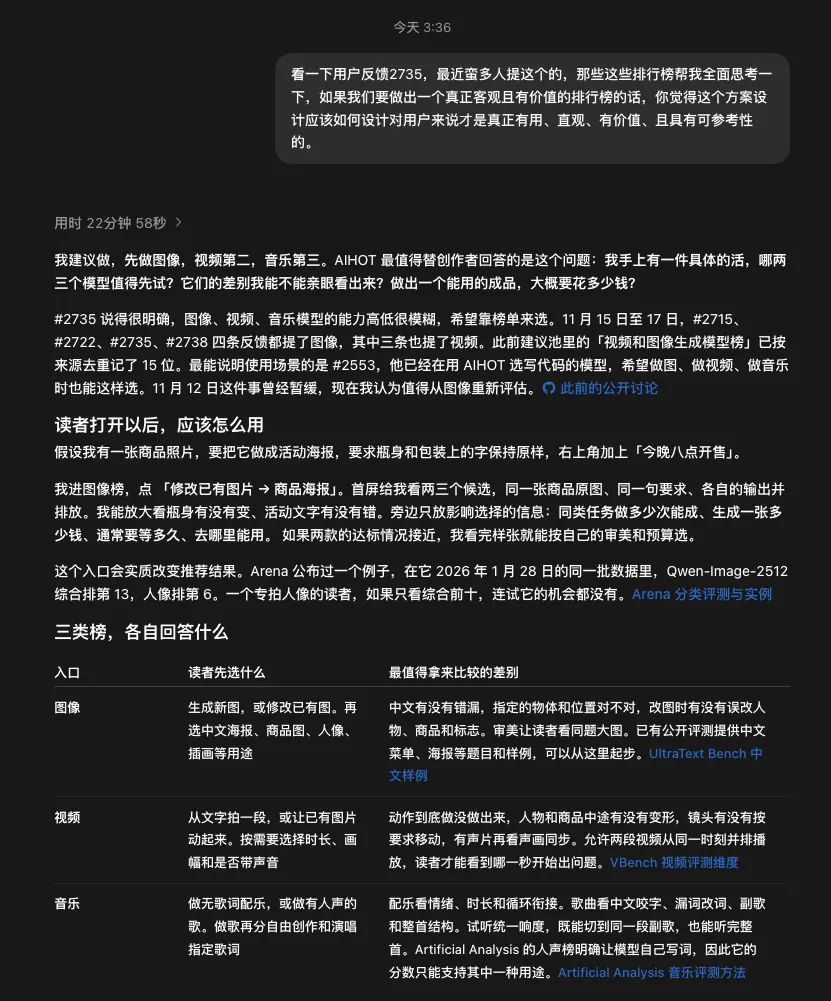
我甚至会觉得,GPT-6.2 Astra的内容可读性和偏主动性的规划能力,好像比初期GPT-6 Astra的感觉还要差一些,在我手上有Claude和Gemini的情况下,我是绝对不会愿意去直接跟GPT沟通任务的,读它的反馈太累了。
然后就是代码审查,这个是我现在用GPT模型用的最多的地方,Claude写完的代码,我都会有一个流程和脚本,是自动地去让GPT审查最多3轮的,因为GPT严谨的性格,所以会挑出来很多的问题和BUG,防患于未然,这个是非常棒的。
我以前的主力审查模型是GPT-6.1 Sol xhigh,然后这次GPT-6.2更新了以后,我用我真实的几个项目来测试了一下,也都是xhigh的推理强度,我觉得这块确实是有大进步。
在我自己构建的非常简易的评测集中,GPT-6.1 Sol只能找出来65%的问题,但是GPT-6.2 Sol达到了84%,GPT-6.2 Astra史无前例的快直接干满了,直接干到了96%。
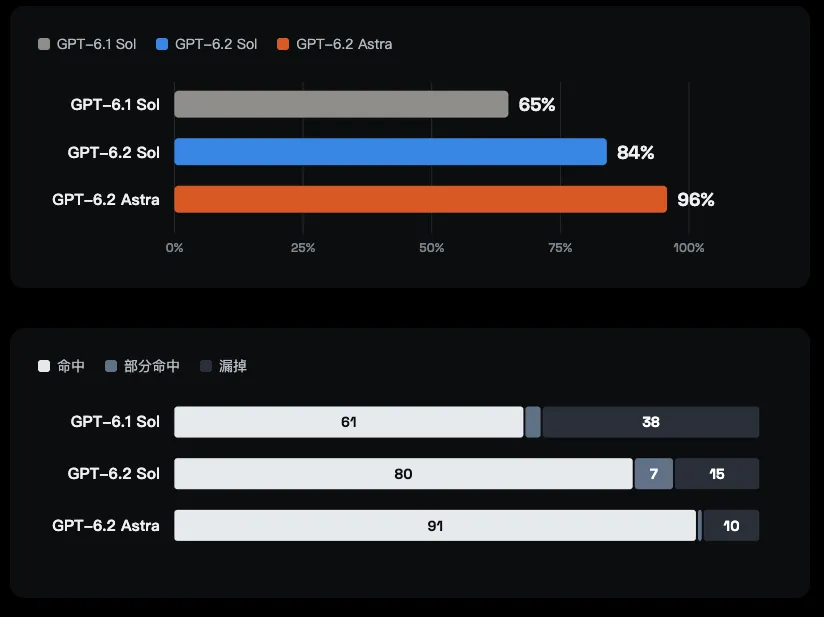
而在价格和时间上,GPT-6.2 Astra相比GPT-6.2 Sol慢了大概一倍,贵了4倍,换来的是多找出了十几个BUG。
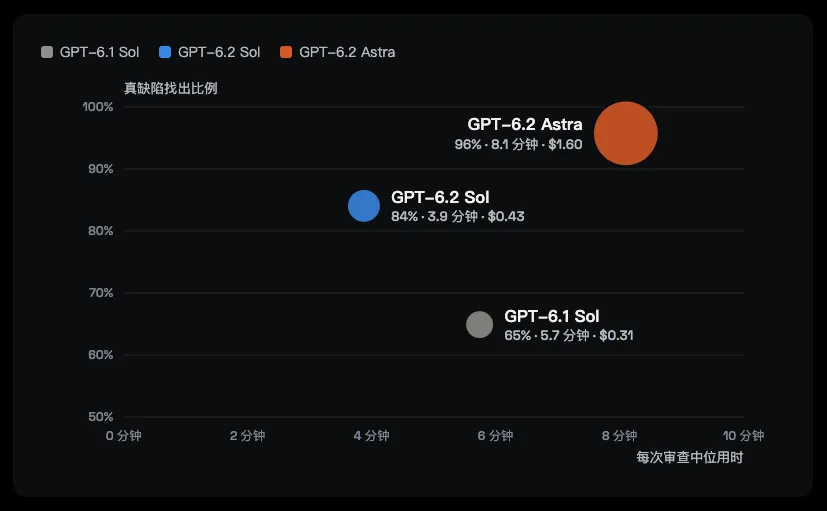
所以未来GPT-6.2 Sol xhigh应该就是我的默认审查模型了,目前确实性价比最强,没有之一。
然后就是大家关心的……审美问题了。
实测的结论就是,除了3D视觉,其他的跟Claude相比……就是一坨屎,哎。
比如说视频,我的老Case,“做一支 40 秒到 1 分钟的 ChatGPT 四周年致敬动效视频(2022.11.30–2026.11.30),16:9 横版,无旁白,配原创音乐。内容自己联网查证,讲这四年的关键版本、里程碑和数字,不得杜撰。动手前先去 OpenAI 官网、博客和近期发布视频里观察他们的视觉风格,提炼后作为这支片子的视觉基调。节奏要快,动效密、画面饱满,随音乐卡点。片子定位是第三方致敬,不要做成 OpenAI 官方出品的样子。”
这是Claude Fable 5.2的。
这是Gemini 4 Carbon的。
而这……是GPT-6.2 Astra的……讲道理,看完我都沉默了……你信我,谁看谁沉默,我感觉是来跟我搞笑的……
这么多年了,OpenAI至今依然不懂,到底什么叫,审美。
而在3D层面上,因为GPT一直在空间视觉上发力,为具身打基础,所以反而强化的比较猛,还是让我比较欣喜的,确实比之前强不少。
比如我们小伙伴搓的一个神庙逃亡,提示词也非常质朴:
“给我做一个第一人称的「神庙逃亡」游戏。极度详细的游戏画面质量,视觉上看起来要能跟 AAA 级游戏匹敌。让它规模小一点,但其他方面要有令人印象深刻的照片级真实图形。”
说实话过程中当我看到GPT给我呈现的是这样一张游戏封面,我就已经知道这玩意儿肯定差不了。
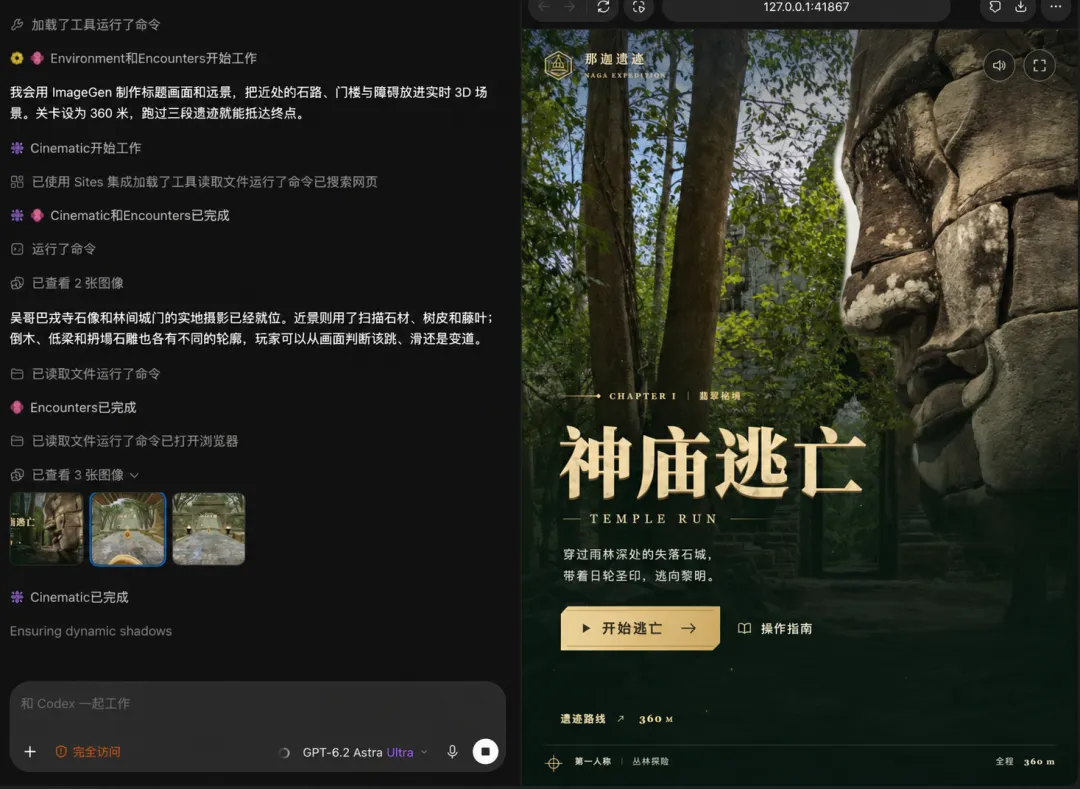
最终跑出来的第一版我发现在玩法的理解上出现了一点问题,于是我简单调了一轮后就得到了下面这样的效果,还是很酷的。
这个质感说实话其实是完全超乎我对 GPT 在游戏方面的预期的。
还有这个 Three.js 做的秋日黄昏乡村小火车站,我也很喜欢。
然后还有一个古希腊世界,同样的,非常简单的 Prompt:
“运用 Three.js,采用极繁艺术风格尽全力还原出最真实、宏伟壮观且复杂的古希腊世界,要求真实细腻,最后交付一个可交互的 HTML 文件。”
对此 GPT-6.2 Astra 第一版跑出来的效果是这样的。
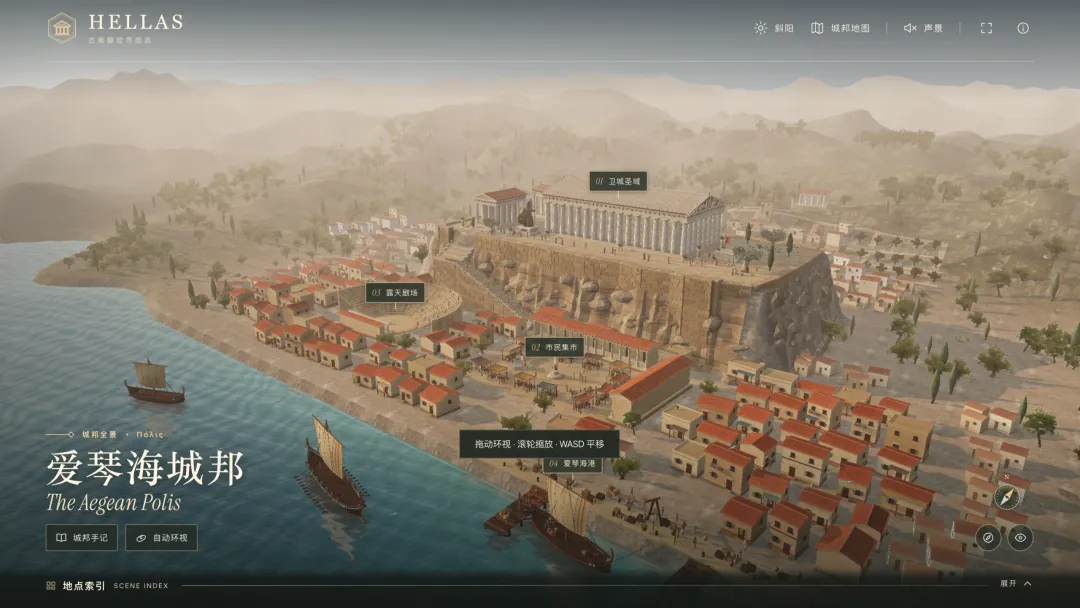
其实已经非常不错了,但我其实并不是特别满意,于是我随便截了一张之前 X 上很火的一个用 Claude 跑了很久的案例的画面给 GPT 让它照着建。
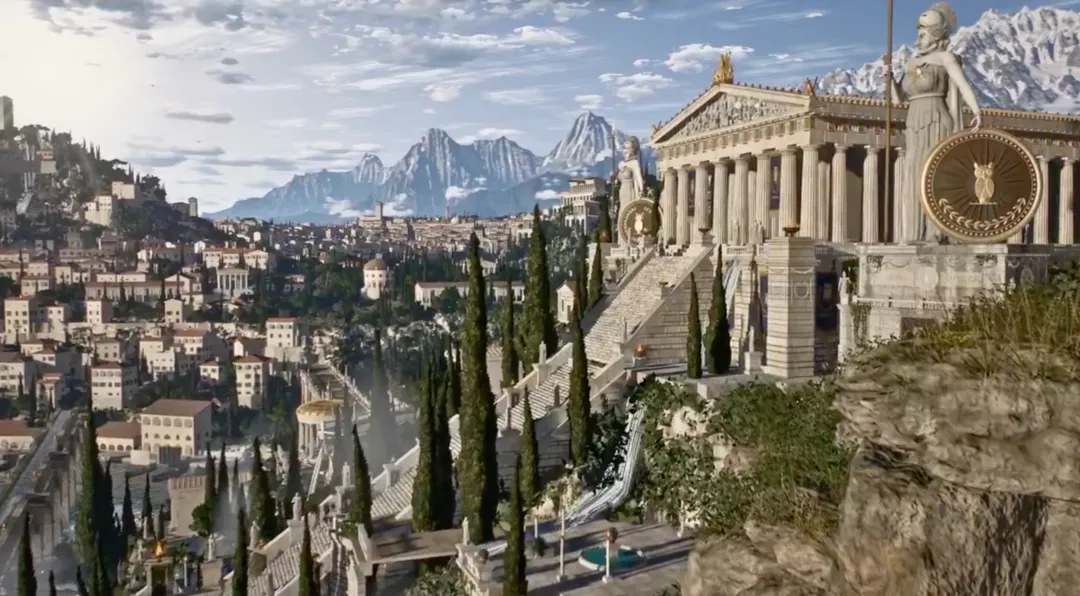
其实我是真不抱什么太大的希望的,但最终耗时一个多小时,GPT 给我交出来下面的答卷,告诉我它可以……
这个效果,说实话,我觉得已经非常牛逼了。
坦率地讲,GPT 系列的模型,已经逐渐开始离普通人越来越远了。
很多人都觉得,Claude 是做 ToB 的,GPT 才是 ToC 的。
但是其实反了。
Claude 的模型,是真正意义上更适合普通人使用的,包括现在的 Gemini 4 Carbon 模型也是这个趋势,他们会更易于沟通,更加主动地思考,去拓展你过去无法拓展的边界。
而 GPT 模型,是真正意义上 To 精英的,因为极其严谨、听话,工业属性极重,对于我认识的科研和算法大佬来说,他们的反馈都是 GPT 模型使唤起来非常顺手,信息密度很高,做的实验非常严谨,可这样的模型,恰恰是不太适合普通人用的。
对于我自己来说,我依然觉得 GPT 的能力很强,特别是在一些严肃任务上,但是确实我太菜了,我的能力不足以让我指挥 GPT。
所以想用好它,我自己的解法就是,承认自己的菜逼,让 Claude 或者 Gemini 大人,帮我去指挥 GPT,这样的体验反而极佳。
这可能,就是我目前认为的最优解吧。
复制本文链接 文章为作者独立观点不代表优设网立场,未经允许不得转载。
数字生命卡兹克
682.8w人气 247文章

发评论!每天赢奖品
点击 登录 后,在评论区留言,系统会随机派送奖品
2012年成立至今,是国内备受欢迎的设计师平台,提供奖品赞助 联系我们
用户体验增长
已累计诞生 795 位幸运星
发表评论
↓ 下方为您推荐了一些精彩有趣的文章热评 ↓