
最近一直在讲课,终于闲下来了。
闲下来以后,我把刷屏的 Jev 接进了自己的产品,结果不到二十个小时,又把它从审核流程里撤了下来。
不过没有彻底删掉。审核换成了 DeepSeek,判重继续让 Jev 跑。
后来又复测了几天,我对它的判断是:
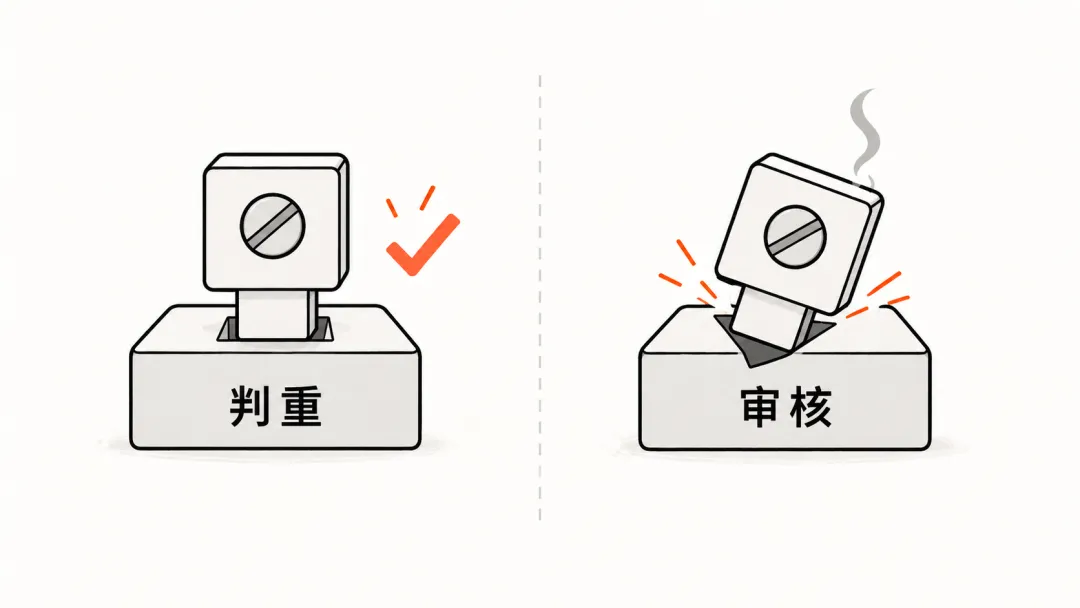
Jev 不是一个更强的生成式 AI,它是一个只做判断题的专用零件。放对位置能省事,放错位置只会添麻烦。
前些天 TypeSafe 发布了 Jev,首页写着最高比前沿大模型快 193.6 倍、便宜 444.6 倍,还说不会出现幻觉。我刷到的内容,几乎都在说这个模型有多牛逼。
我只关心一件事:这些卖点放进真实流程里,还能剩多少?
我拿 30 场真实的面试复盘去测,让它判断每一场合不合格。
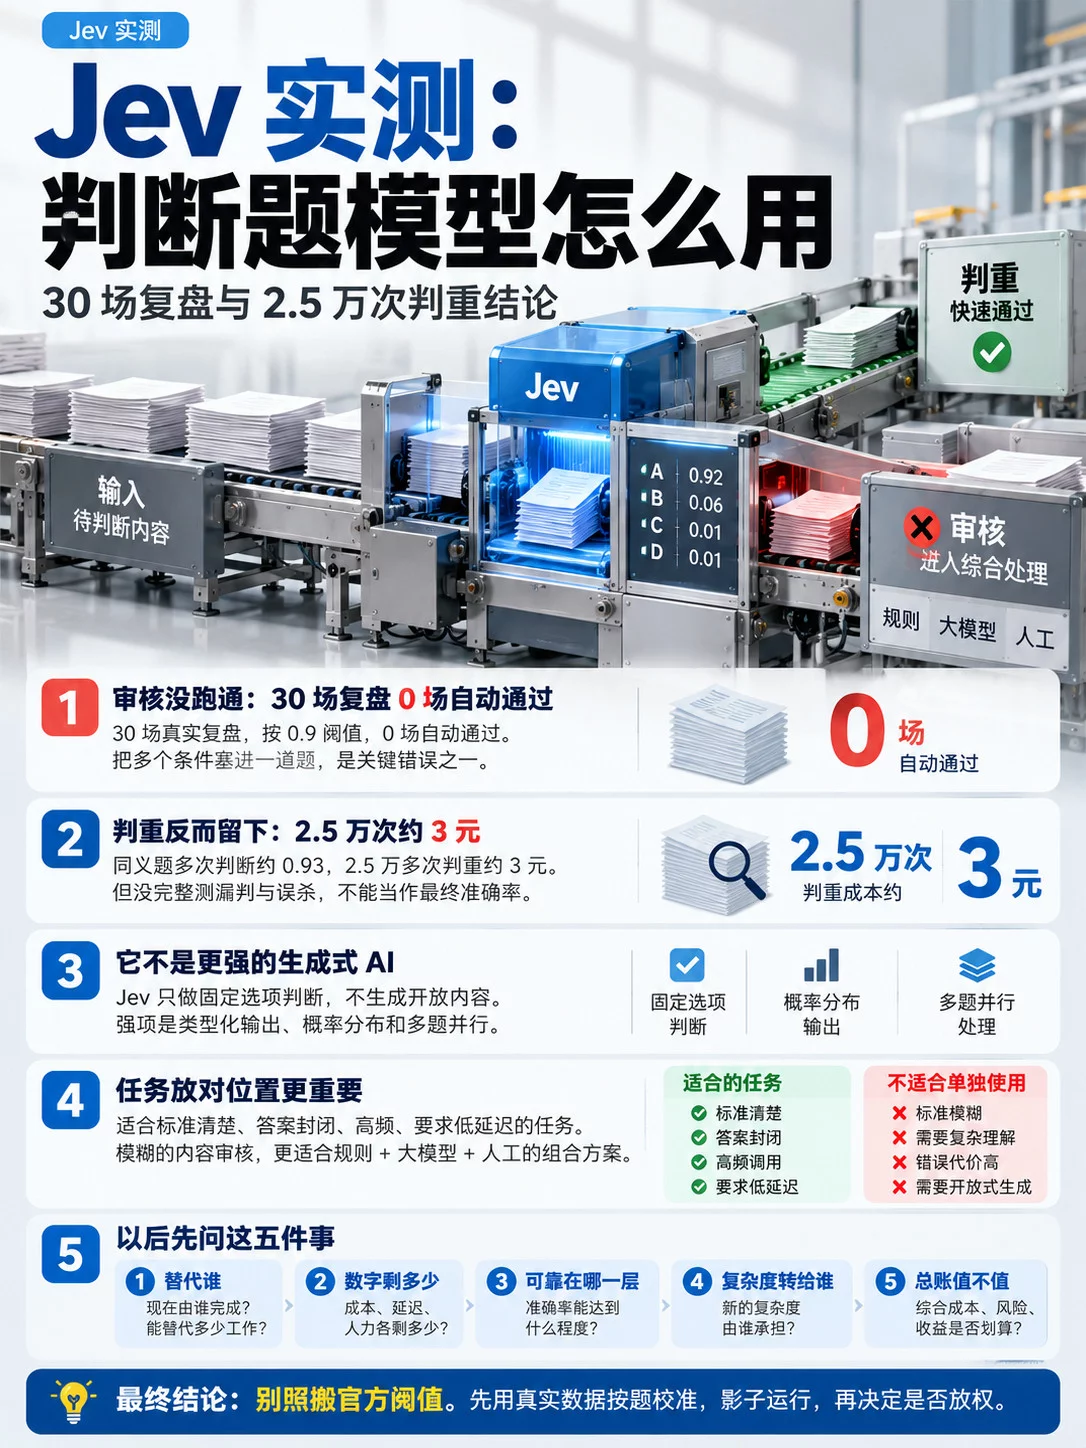
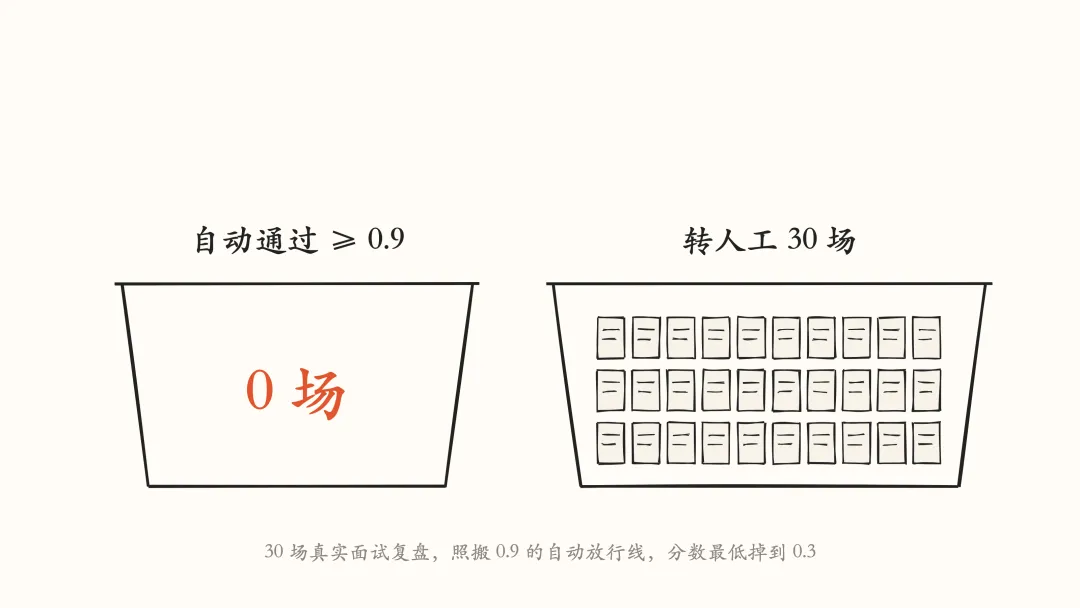
按我当时定的 0.9 自动放行线,30 场里,一场都没自动通过。
分数最低掉到 0.3。我改了问法,也只爬到 0.4 到 0.55。当时我脑子里就一句话:
这他妈到底是个啥玩意儿?
我不信邪,自己造数据,换问法、换语言、换题型接着测,前前后后折腾了好几天。最后审核还是没跑通,判重倒是留了下来。
回头看,锅不全是模型的。我照搬了官方案例里的阈值,还把三个条件塞进了同一道题。更要命的是,什么叫「合格」,我自己都没想清楚。
这几天折腾下来,我整理出五个问题。下次再有新模型刷屏,我会先拿它们挨个问一遍。
我想让它做什么
我手上正好有个现成的场景。
这个产品要把学员的面试复盘汇总成题库。每篇复盘进来,要过两道判断:
- 判重:这道题和题库里已有的,是不是同一道?
- 审核:这场复盘合不合格,能不能直接入库?
两道都是判断题,看着就是 Jev 的主场。我把它写进了产品需求文档,当时的理由是这么写的:
输出是校准过的概率,可以直接按阈值分档(≥ 0.9 自动、0.5–0.9 人工、< 0.5 否),且单次判定比 LLM 快、便宜一到两个数量级。
我想得很简单:Jev 判合格的自动入库,我只看中间那一小撮拿不准的。
现在回头看,这段话里的判断全是从官方材料里搬来的,没有一条来自我自己的数据。0.9 这条自动放行线,也是直接照抄的官方案例。还有一处我当时没分清:Jev 的是非题给的是「是」的概率,选择题和打分题给的是置信度,这是两种不同的分数,我却把它们当成了一回事。
结果:审核几乎全卡住了
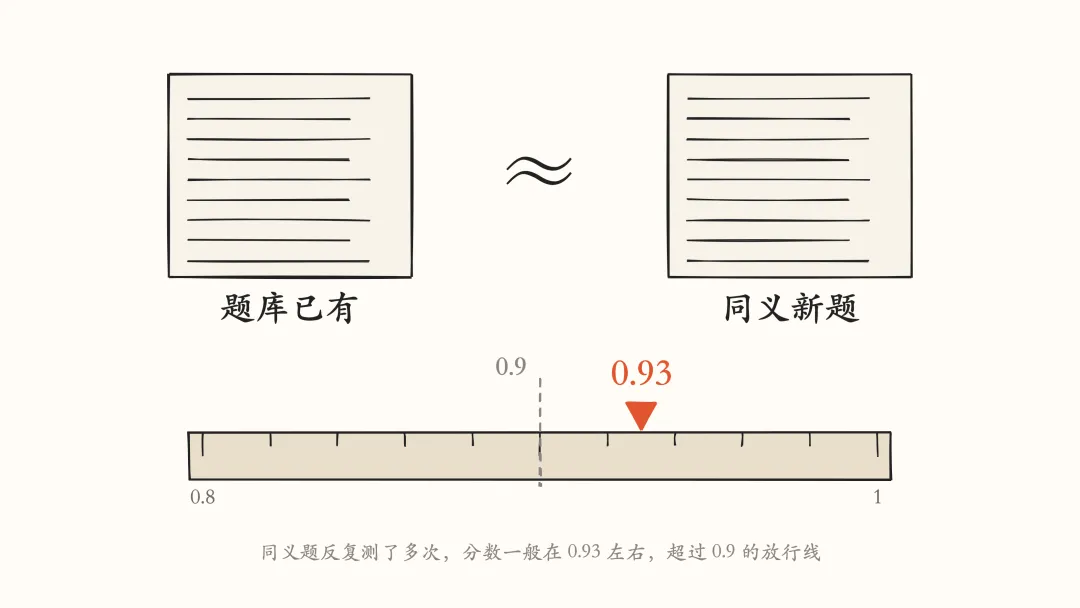
判重这边,我拿同义题反复试,它一般能给到 0.93 左右,所以我把它留在流程里接着跑。不过我没专门测过它会漏掉多少重复题、又会误杀多少不同的题,所以这只能算一个正向信号,还算不上准确率。
审核那边,完全是另一回事。
30 场真实面试复盘试跑下来,0 场自动通过,30 场全部转人工。开头那句脏话,就是这时候骂出来的。我接 Jev 本来是为了少看几篇,结果一篇没少。
回头排查,问题不全在模型,有一部分出在我自己的接法上:一道题里,我塞了三个条件。
我写给 Jev 的审核题目是这样的:
这是一场被正确解析的真实面试:公司名是一家真实公司(不是题库、话术这类文档标题),轮次合理,题目是面试官实际会问的问题(不是备考清单、不是文档标题的碎片)。
公司名是真的、轮次合理、题目是面试官问的,三个条件同时满足才算合格。
可学员复盘里的公司名,经常没清洗干净。比如多了个下划线的「红熊 AI_ 」,或者公司名、业务、岗位拼成一长串。这种人扫一眼就能改的小毛病,把好几场完全正常的面试拉到了 0.30 到 0.45。
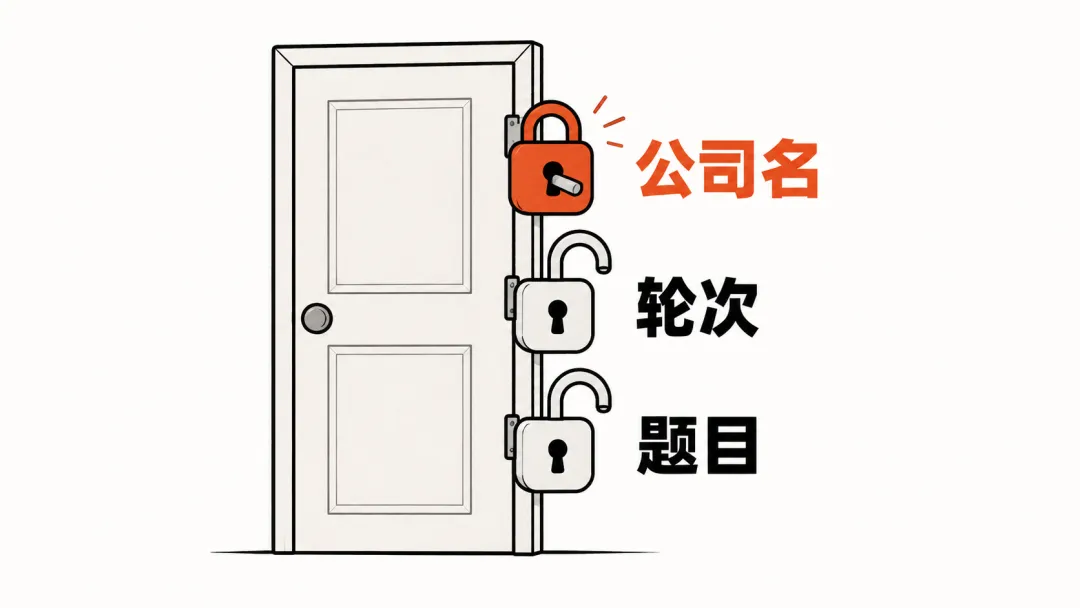
官方文档其实写得很清楚:一道题只问一件事。我就是这么踩进去的,先露馅的是我的接法。
我改了什么
我把题目改成只问一件事:
这些题目是不是面试官真实问的。
公司名脏不脏、轮次对不对,本来就是审核页上人工一眼能修的事,不该决定一场面试能不能入库。
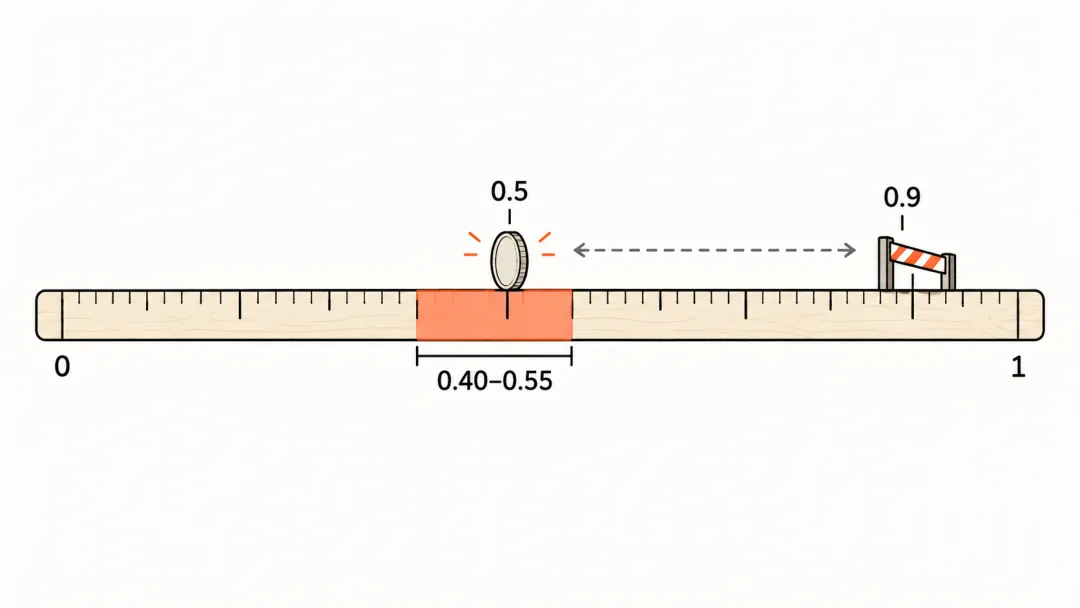
重新测了 10 场,分数集中在 0.40 到 0.55。其中一场有 26 道题,我人工一道道核过,确实都是面试官真问出来的,Jev 给了 0.42。
这 10 场,还是没有一场够到 0.9。
当时 Claude 给了我一个解释,我觉得说得通,但还没验证过,只能先当个猜想:
它对「这是不是真的」这类开放判断天然保守,很少给出 0.9 以上。而 0.9 这个阈值是为「两道题是不是同一道」这种有明确答案的判断定的,那类判断 Jev 确实能给 0.93。
是非题的 0.5 跟抛硬币差不多,Jev 给我的 0.40 到 0.55,全挤在是和否的分界线附近。拿这种分数去自动放行肯定不行,它更像是在提醒我,材料、题目和阈值这三样都还没调通。
我的决策
我回了 Claude 一句:
那还是交给大模型来自己判断吧,怎么样?
当天晚上,代码提交:判重继续用 Jev,审核换成 DeepSeek。 从凌晨想到接 Jev,到晚上把它从审核里撤下来,不到二十个小时。
为什么是 DeepSeek?考虑很简单,它比 Jev 贵一点,但也够便宜。在我这个量级下,这点价差不值得我继续跟 Jev 在审核上死磕。
后来审核定成了三层:先过规则,比如有没有公司名、轮次认没认出来;再看 DeepSeek 打分;两边都达标的,我在后台一键确认。我没做严格统计,只说体感:通过的那批整体质量不错,没通过的大多也能看出明显问题。最难啃的那部分活,这套流程确实替我扛下来了。
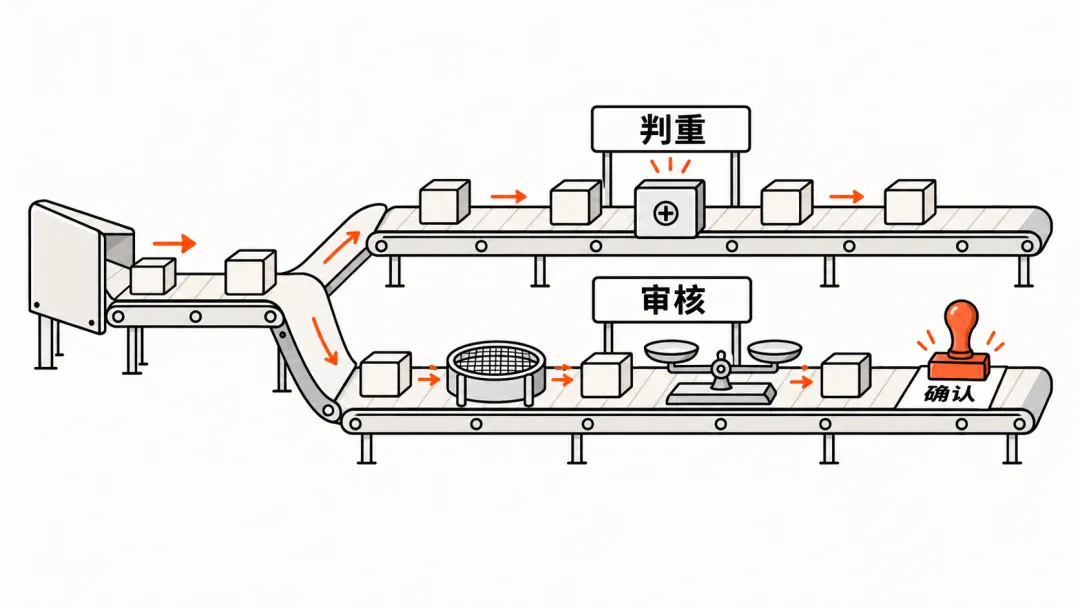
下面是那一天两条流程的实际账单。两边干的活、样本和输入都不一样,不能当成模型对比来看。我只想算清一件事:落到这个产品里,到底省了多少钱。
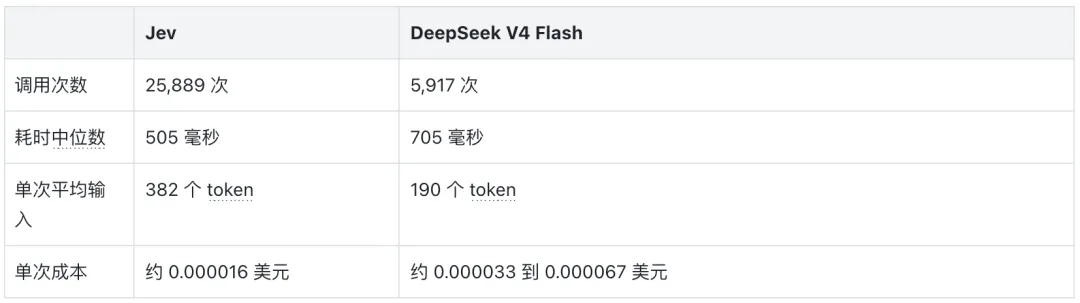
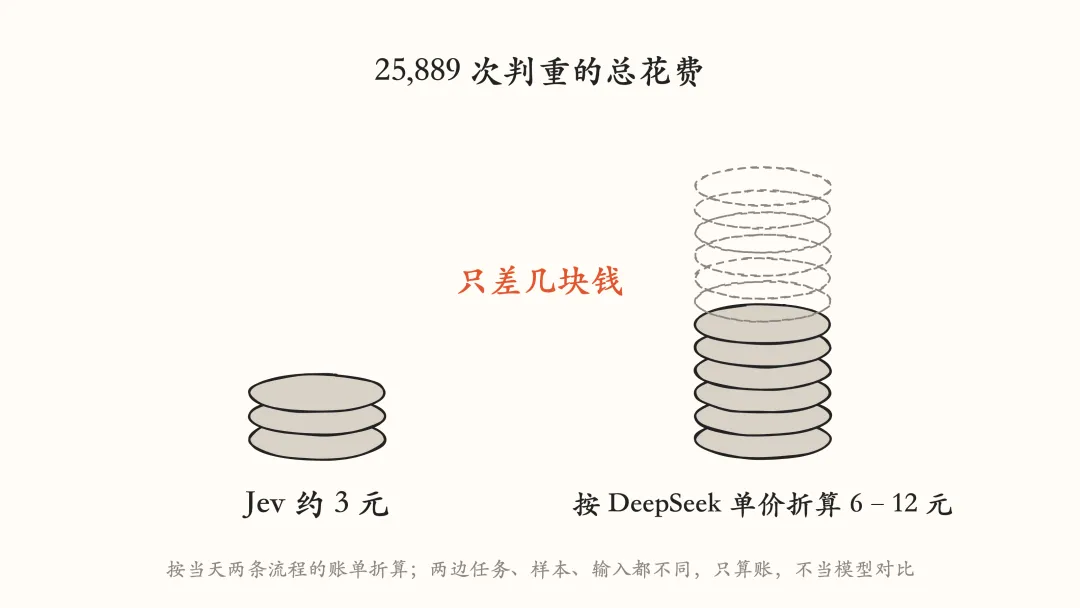
两万五千多次判重,Jev 一共花了大约 3 块钱;按 DeepSeek 的单价粗算,同样的量大约是 6 到 12 块钱。至于官方说的 193.6 倍和 444.6 倍,跟这组数据不是一个测法,没法放在一起比。
省下来的,就是几块钱。
我不信邪,又复测了一遍
撤下来之后,我还是想弄清楚:到底是模型不行,还是我不会用?
于是又做了一次小样本复测。我造了两份材料:一份是真实风格的面试记录,公司名故意写成带下划线的「红熊 AI_」;另一份是备考题库,公司名就写「题库」。两种问法各问一遍,再拿 DeepSeek 当参照。材料就这么两份,只能看看之前的现象会不会再出现,算不上严格的对比测试。
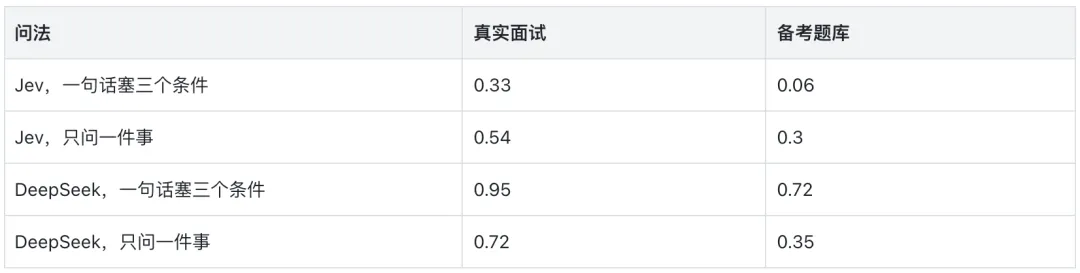
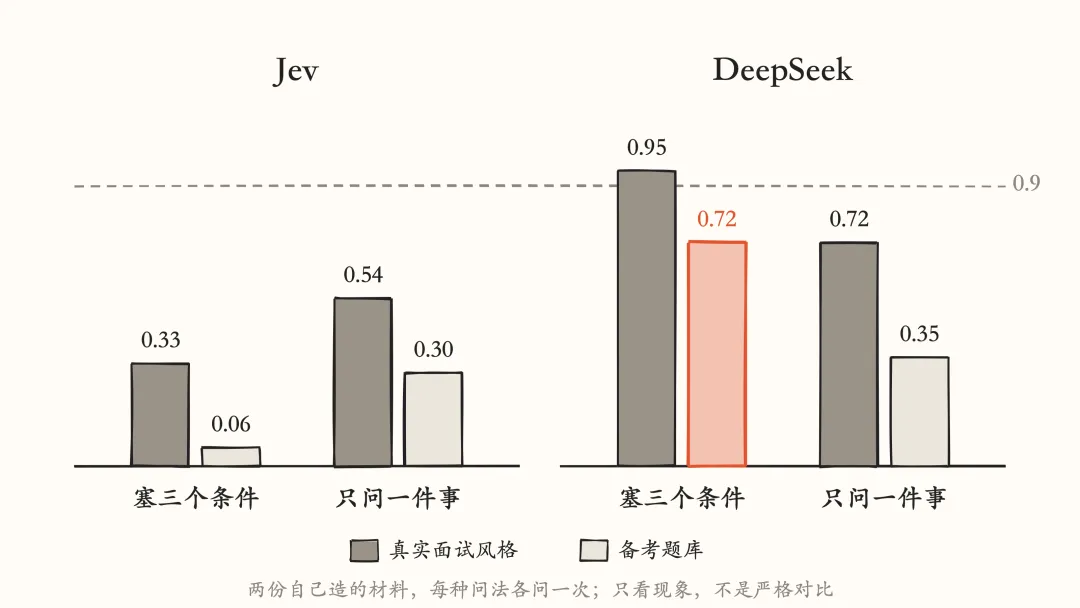
先看问法。同一份真实面试风格的材料,一道题塞三个条件时是 0.33,只问一件事就升到了 0.54。项目里遇到的情况,又出现了一次。
更意外的是,在这两份材料上,Jev 的排序其实是对的。不管怎么问,真实面试的分数都比题库高。它没把两份材料搞混,只是两边都够不到我照搬来的 0.9。反倒是 DeepSeek,在塞三个条件的问法下,给一份明明写着「题库」的材料打了 0.72。
如果当初我按题去调阈值,而不是照搬 0.9,结果可能完全不一样。
为了写这一节,我读了官方一百多页文档和 18 个案例,也把创始人两个多小时的播客听完了。
读完之后,我给它的定义还是那句:
Jev 是一台只做判断题的机器。
你给它一段材料,再给它几道题,它直接告诉你每道题选什么,以及对每个选项有多大把握。
它不聊天,不写文章,不写代码。你让它说一句「你好」,它都做不到。
听起来像个很弱的模型。但官方在发布博客里专门写了一句:
Jev is neither small nor an LLM. Jev
既不是小模型,也不是大语言模型。
打个极端点的比方。假如今天有人发布一个模型,速度比普通大模型快 1 万倍,完全没有幻觉,永久免费,但它只能做一件事:两个数的加法。
你会觉得这个模型颠覆吗?不会,你只会觉得发布它的人在耍你。
话糙理不糙。判断这件事,大模型本来也能干。Jev 只是把它单独拎出来,往快、便宜、带概率、能让代码直接用这几个方向做到了头。 你要是需要又快又稳地做一大堆判断,可以考虑它。但它的速度和价格,只在这一小块任务里成立,推不出它比大模型更聪明。
不过判断和加法不一样。加法可以写死成一段代码,判断写不死。「这条消息紧不紧急」,你没法用 if-else 穷举。所以 Jev 还是得读懂自然语言,只是回答被限制在你事先给定的几个选项里。至于它内部到底是什么结构,官方没公开。
写作文的考生,和涂答题卡的考生
想象两个考生,做同一道阅读理解。
第一个考生习惯写作文。读完材料,一个字一个字往下写:「根据材料第二段,客户提到集成失败了三天,这说明问题属于技术类,因此我认为答案是……」写了三百字,答案藏在第三百零一个字里。
你想知道他选了什么,得把作文读完,再从里面把答案抠出来。
第二个考生只涂答题卡。读完材料,直接把 B 涂黑,旁边标一句:B 有八成把握,A 有一成五,C 基本不可能。
生成式大模型更像第一个考生,Jev 更像第二个。当然这个比方只是个大概,现在的大模型也能按要求只交一张格式正确的答题卡。
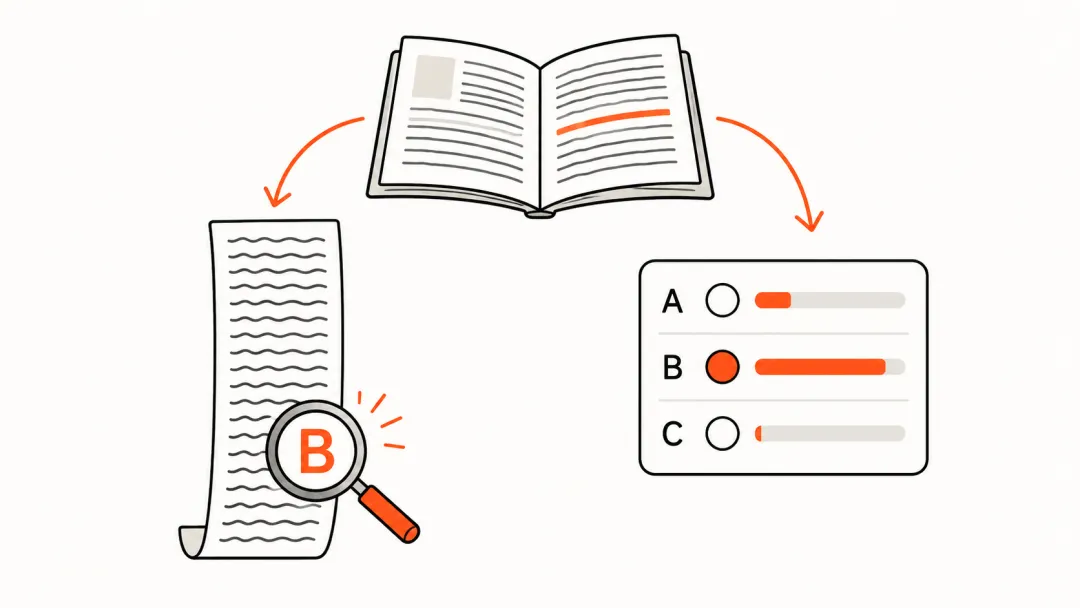
如果从技术逻辑来说:
大语言模型是自回归的,一个 token 接一个 token 往外生成,每一步都依赖前面写过的内容。开了严格的结构化输出,它也可以只吐一个选项或者一小段 JSON,只有你让它解释理由时,才会越写越长。Jev 的不同在于,它天生只返回你定义好的类型,外加每个选项的概率。
Jev 不生成文字。一份材料加所有题目放进一次请求,它会并行给出每道题的答案和概率分布。
TypeSafe 把这类模型叫 System One Model,名字来自卡尼曼的《思考,快与慢》:系统一是快的、凭直觉的判断,系统二是慢的、一步步推理。
官方很清楚这个名字有风险,自己在博客里写了:
'System 1 thinking' has also implied error-prone.
「系统一思维」这个说法,也暗示着容易出错。
他们的回应是,相信 System One 模型能比替代方案更可靠。这句话对不对,我的测试回答不了。我能回答的只是:它放进我的流程以后,实际发生了什么。
只涂答题卡,带来三个后果
最直接的一个:它不可能答出选项以外的东西。
你给它三个选项,它只会在这三个里选。不会冒出第四个,不会输出一段格式错误的 JSON,也不会回你一句「作为一个 AI 模型,我无法……」
这就是 TypeSafe 这个公司名的来历:类型安全。你的代码要一个三选一的值,它就一定给你一个三选一的值。
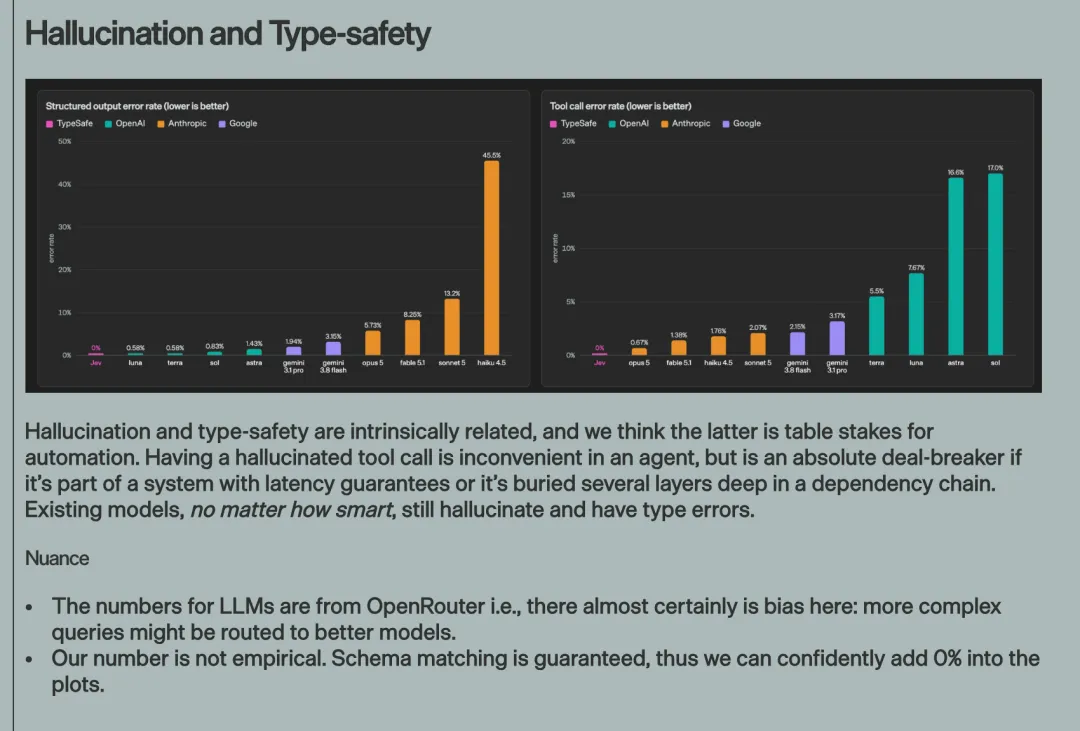
如果你是让大模型用普通文本自己拼 JSON,这一点确实很珍贵。官方博客列过一组数据:在 OpenRouter 上,主流大模型的结构化输出错误率从 0.58% 到 45.5% 不等。不过也得说句公道话,现在不少模型 API 已经支持严格的 JSON Schema,格式正确早就不是 Jev 独有的本事了。Jev 真正不一样的地方,是它从接口到训练目标,都奔着「在固定选项里做判断」这一件事去设计。
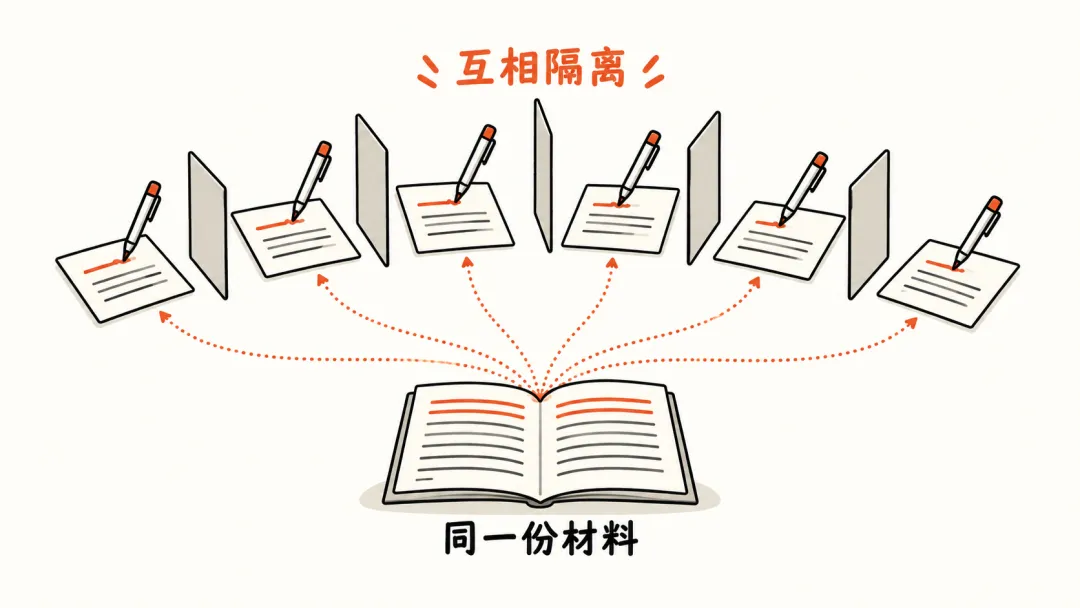
第二个:一次问十道题,和问一道差不多快。
官方原话:
Every question is evaluated in parallel and in isolation against the same state in one go. Adding questions barely changes the response time.
所有问题针对同一份材料,一次性、并行、互相隔离地作答。多加几道题,响应时间几乎不变。
官方做过一个测试:一篇五万多字符的 GDPR 文章,挂 13 道题。一次性发送,比 13 道题分开发便宜 12.2 倍、快 10 倍,答案还不变。
不过互相隔离也有代价:第一道题的答案,第二道题是看不到的。如果第二道题要依赖第一道的答案,就只能拆成两次请求。
第三个:每个答案都自带把握程度。
你用普通聊天接口问大模型,它给你一个答案,不会顺手附上一组「每个选项各有几成把握」的概率,更别说是专门为判断任务训练和校准过的。Jev 的选择题和打分题会返回完整的概率分布,是非题直接返回「是」的概率。
这个概率,是 Jev 最核心的卖点,也是我栽得最狠的地方。
三种题型:选择题、打分题、是非题
Jev 只支持三种题型。
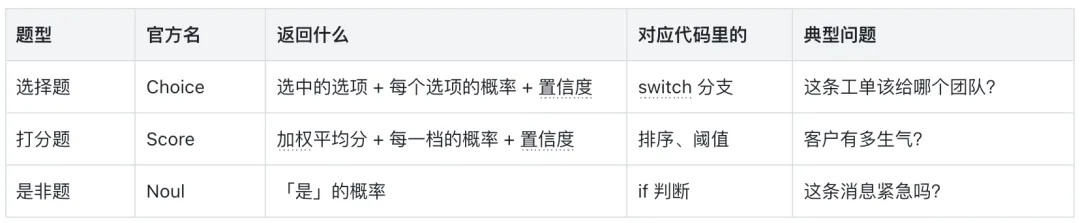
是非题叫 Noulli,名字取自伯努利(Bernoulli)的后半截。
创始人 Diogo Almeida 在播客里把这三种题型和编程结构一一对上了:
Choice maps into a switch statement on an enum. Noulli's mapped to if statements. And scores map to sorting or thresholding.
选择题对应枚举上的 switch,是非题对应 if,打分题对应排序或阈值。
Jev 从一开始就是给代码用的。
看一个官方示例。一条客服消息进来:
「我这三天一直在尝试连接 Stripe 账户,集成一直失败,我在损失销售额。请尽快帮忙。」
一次请求,同时问三道题:该给哪个团队?客户有多生气?紧不紧急?请求写起来很简单:state 放材料,questions 放题目,每道题写清两件事,instructions 写你要判断什么,criteria 写可能的答案有哪些(完整代码在后面「往下挖一层」里)。
返回结果:
"department": {"choice": "technical", "confidence": 0.78,"probabilities": {"technical": 0.85, "billing": 0.15, "sales": 0.0} },"frustration": {"score": 1.0, "confidence": 1.0 },"is_urgent": { "noul": 1.0 }翻译人话:
- 归技术团队,85% 的把握;也可能是账单问题,15%;
- 客户在「有情绪但还算礼貌」这一档;
- 紧急,确定。
整个请求 392 个 token,官方说大多数请求 100 毫秒左右就能返回。
置信度到底是什么?
上面的结果里,技术团队的概率是 0.85,置信度却是 0.78。这两个数有什么区别?
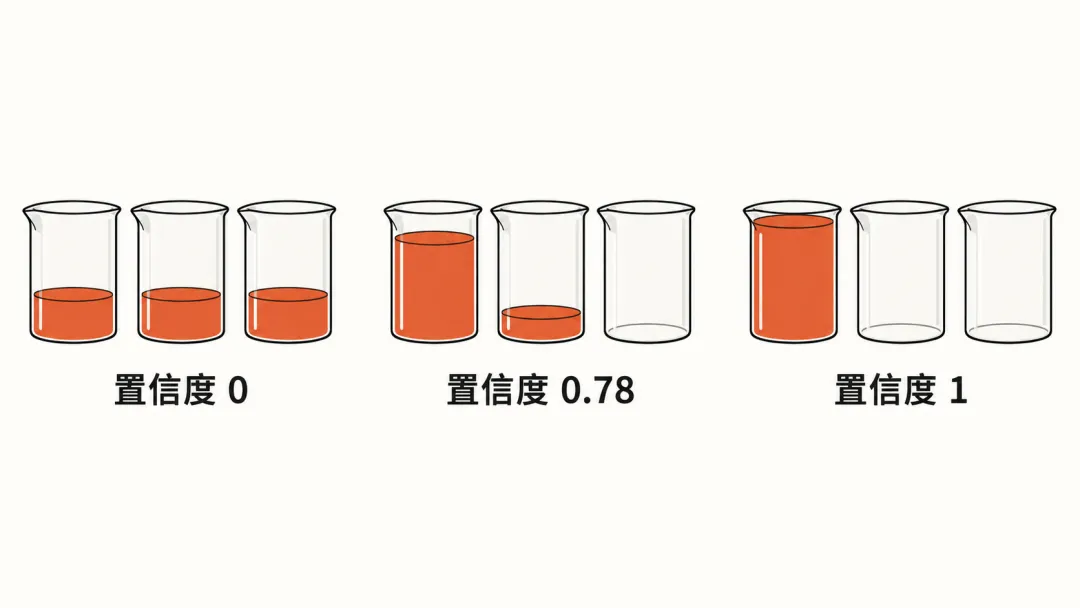
概率说的是每个选项各占几成,置信度说的是这组概率有多集中。
三个选项,如果是 0.33、0.33、0.33,模型完全拿不准,置信度是 0。如果是 1、0、0,模型非常确定,置信度是 1。
官方文档的演示里给过一个近似公式:
三个选项时,置信度约等于(3 × 最大概率 − 1)÷ 2。代进去算:(3 × 0.85 − 1)÷ 2 = 0.775,四舍五入就是 0.78。
还有两个数,我都踩了坑。
是非题的 0.5,不是「程度中等」,是「是和否一样可能」。
官方文档专门提醒过:你问它「这个候选人 Python 强吗」,它给 0.5,意思不是「一般强」,而是「我不知道,像抛硬币」。想问程度,得用打分题。我审核里拿到的那堆 0.4 到 0.55,就是这种情况。
另一个是「校准」。所谓校准,意思是模型说有 0.2 概率的事,放进一大堆判断里看,大概真有 20% 会发生。它说的是一大批判断的整体表现,不保证单个答案。
官方原话是:
These rates describe groups of predictions, not a guarantee about any single answer.
这些比率描述的是一批预测,不是对任何一个答案的保证。
官方给开发者的说明文档里,还有一句更直白:
Typed output guarantees the interface, not truth.
类型化的输出保证的是接口,不是真相。
往下挖一层:从代码看,它到底省掉了什么
我又把这点差异放到代码里对比了一下。
同一个任务:一条客服消息进来,判断该交给哪个团队。
如果用普通文本接口,自己解析 JSON,代码大概长这样:
prompt = f"""判断这条客服消息该交给哪个团队,只能从 billing /technical/sales 里选一个,再给出 0 到 1 的把握程度。只输出 JSON,例如 {{"team":"technical","confidence": 0.8}}。消息:{message}"""
for attempt in range (3): # 格式错了就重试,最多三次
text = llm.chat (prompt) # 模型逐 token 生成回答
try:
result = json.loads (text) # 它可能多说了一句「好的,以下是结果」,解析失败
if result ["team"] in ("billing", "technical", "sales"):
break # 它也可能编出一个不存在的团队
except ValueError:
continue
这种接法里,真正在做判断的只有一行,剩下的都在对付文本格式。开了严格结构化输出以后,这部分能少一大截,所以也不是所有大模型调用都得背这么多防错代码。
还有个更隐蔽的问题:这里的 confidence,只是模型在文本里顺手写出来的一个数字。它写 0.8,不代表它打 0.8 的那些答案真有八成是对的。
用 Jev 做,代码长这样:
resp = requests.post("[ https://api.typesafe.ai/v1/systemone](https://api.typesafe.ai/v1/systemone)" , headers=headers, json={
"state": message,
"model": "jev-latest",
"questions": {"team": {
"type": "choice",
"instructions": "Which team should handle this",
"criteria": {"billing": "付款或订阅问题", "technical": "故障或集成问题", "sales": "价格或账户咨询"},
}},
})
team = resp.json ()["answers"]["team"]
team ["choice"] # 一定是三个之一,不用从自由文本里提取
team ["probabilities"] # 接口直接返回每个选项的概率分布
不用自己从一大段文本里抠选项,也不用为了 JSON 格式手写重试。
Jev 真正卖的就是这些:原生的类型化判断、概率分布,还有一次并行回答多道题。至于能帮你省掉多少防错代码,得看你原来用的是普通文本接口,还是已经开了严格结构化输出。
官方自己承认的边界
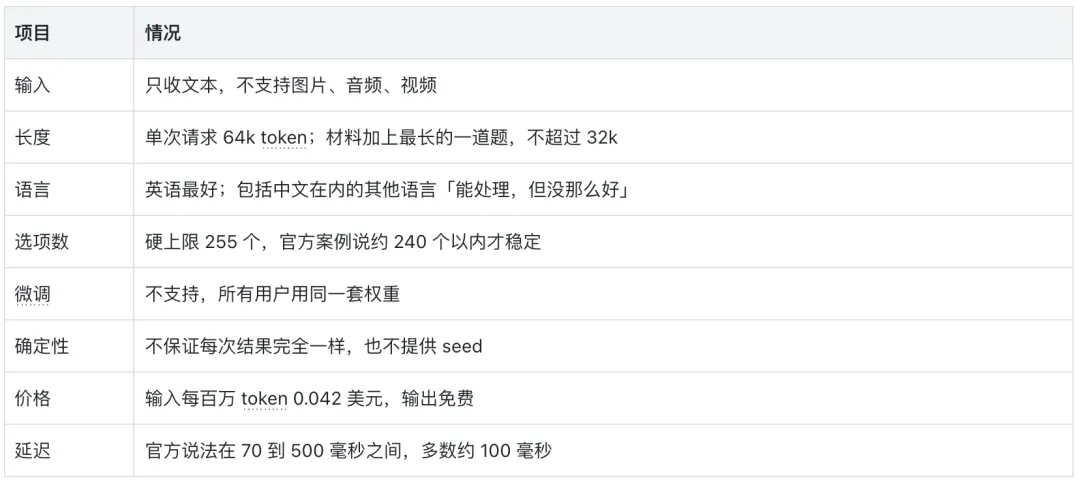
中文那一条,官方原话是:
Other languages, including CJK scripts, are handled but not equally well. 包括中日韩文字在内的其他语言,能处理,但没那么好。
做中文产品的,这一行要加粗看。
我自己验了几条
官方列的边界和短板里,我挑了三条,用自己编的材料简单复测了一下。每条就两三道题,只能看个现象,推翻不了官方结论。
- 日期和计数。 官方说它把日期当文字读,也不擅长数数。我试了两道简单题:「3 月 15 日签合同,3 月 8 日截止,截止在签订之后吗」,它给 0.01,答对了;「苹果、香蕉、苹果、梨、苹果、橙子、苹果,一共几个苹果」,它选 4,也对了。至少在这两道简单题上,官方说的短板没出现。
- 互斥的问题怎么问。 官方例子里,分别问「要退款」和「不要退款」,两个是非题的概率加起来是 1.19。我拿一条中文工单测,结果是 0.87 和 0.17。这是两道各自独立的题,本来就不会互相凑成 1,所以不能拿加起来等不等于 1 来判断它自不自洽。真想表达二选一,应该用一道选择题,或者只问一道是非题,另一个结果让代码取反。
- 中文和英文。 我问「用户是不是要转人工」。「你是机器人吗」,英文 0.21,中文 0.07;「我已经问了三遍了,能不能让我跟真人说话」,英文 0.99,中文 0.98。每句连问三次,结果几乎一样。样本太小,只能说在第一句这种有歧义的材料上,中文分数更低,还说明不了中文整体更保守。
它是怎么做出来的:事实和猜测要分开
原理这块,我最怕写过头。官方目前能确认的只有四件事:
- 官方说用了三样东西:新的模型架构、并行采样器,还有一种叫 RLCD 的训练方法,也就是面向校准决策的强化学习。
- RLCD 没有论文。播客主持人问起,Diogo 回答「No, not yet」。他还说 RLCD 的关键在训练目标本身,具体用什么算法不重要:It's not about the PPO. That part doesn't matter.
- 训练数据全是合成的,不用任何用户数据。官方原话:We wouldn't train on your data even if you asked us to. 理由是真实数据偏差太大,会让模型过拟合于当下。
- 官方没有公布常见公开基准的分数。
剩下的就都是猜测了。
官方没公开架构。社区里比较常见的一种猜法是:保留语言模型理解文字的那部分,把自由生成文字换成只给固定选项打分的模块,再用 RLCD 去优化判断和概率。
这种猜法能解释一部分公开现象,但不等于 Jev 真是这么做的。完整猜法和示意代码,我放在文末附录,想深挖的可以去看。
参数量多大、具体什么结构,到现在都没公开。所以看到有人言之凿凿地说「Jev 其实就是 XX」,可以先打个问号。
为了弄清 Jev 为什么会爆,我把融资公告、媒体报道、Hacker News 五百多条评论、各渠道的接入博客和创始人播客都翻了一遍。没找到 TypeSafe 买量或雇水军的证据,看下来更像是几件事凑到了一起。
先是它确实戳中了一个大家都遇到过的痛点。官方博客第一句话就问:
Models have been superhuman at chat for years, so where is all the automation?
模型聊天早就超越人类好几年了,那自动化到底去哪了?
大模型聊天很强,可一接进业务流程就不是那么回事了。格式对不对只是第一关,后面还有概率能不能用、判断能不能稳稳地接进代码、多个问题是不是要反复调用。严格结构化输出已经解决了一部分 JSON 的问题,Jev 卖的是更窄的一件事:让「判断」本身变成软件能直接调用的接口。
团队履历又把这句话放大了一轮。创始人是 InstructGPT 的作者之一,团队来自 OpenAI、Google Brain、Meta。顺便纠正一个说法:有些媒体叫他「RLHF 的发明人」,这是夸大了。
随后,Vercel、LangChain、OpenRouter 三天内全部接入。Vercel 宣布 Jev 是它历史上被采用得最快的模型,可那一周 Jev 在 Vercel 上是免费的。没有证据说是 TypeSafe 出的钱,我更愿意理解成,渠道自己也要抢开发者的注意力。
发布一周后,官方发布视频在 X 上显示大约 4000 万次观看;我找到的一条唱反调的实测帖,只有 4 万多次。两个帖子代表不了全部舆论,但能看出这轮传播有多不对称。
资本新闻把音量推得更高。9 月 15 日,TypeSafe 公布了 4000 万美元种子轮,媒体援引 PitchBook 的数据,说估值 2 亿美元。9 天后,The Information 报道公司开始谈一笔 10 亿美元以上的融资,还有没具名的投资者给出了 100 亿美元以上的估值意向。后面这个还只是早期洽谈,不是已经完成的融资,不能直接写成「估值涨了 50 倍」。
Jev 这个名字取自杰文斯悖论:东西越便宜,用得越多。它赌的是,判断便宜到一定程度,调用量就会爆炸。官方自己也承认,现在还没法证明这个价格没有补贴。光凭这些材料,我不会说它是一场资本局,只能确认融资消息确实又给热度添了一把火。
两个数字,一定要会拆
官方发布博客里写过一句:「非凡的主张需要非凡的证据,收据在下面。」拆之前,先看个彩蛋。
我把官方发布博客开头那段原文原样丢给 Jev,问了三个问题:
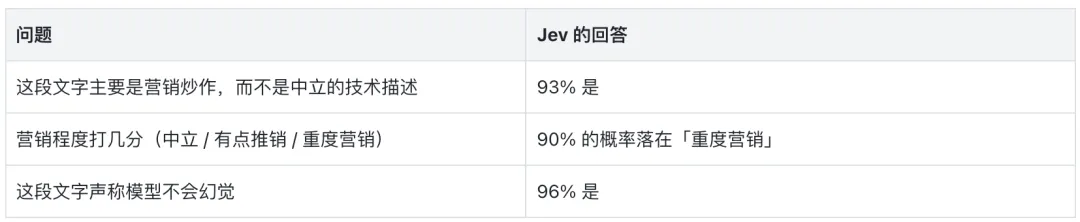
连跑三次,结果几乎一样。当个彩蛋看挺讽刺的,但它证明不了官方宣传一定夸大。
快 193.6 倍、便宜 444.6 倍。 这组数字背后有三个前提:
- 题是 TypeSafe 自己出的,测试用的工作流也是他们自己搭的;
- 答案不是人工标的,而是取 GPT-6 Astra 和 Claude Fable 5.1 的平均预测,所以图里那个 67.8%,更接近「跟这套参考答案对上了多少」;
- 拿来比的对手里,有需要先推理一轮的前沿模型。
官方自己也写了,这组倍数处在真实收益的偏高一端。另一组第三方测试用了 791 条带标签的数据,Jev 在延迟中位数上的优势是 2 到 3.6 倍左右,具体差多少,还要看任务和对手。
零幻觉。 官方图表下面有一行小字:
Our number is not empirical.
我们这个数字不是实测的。
这个 0% 保证的是格式,业务判断对不对,不在它的承诺范围里。Flask 的作者 Armin Ronacher 说得更狠:它把幻觉问题转交给了用户,如果它只给你 50% 的概率,那可能就是在抛硬币。
挤掉水分,还剩什么
- 输出永远落在你定义好的选项里,不用解析一大段文本,也不用为格式出错重试;
- 一次问很多题,几乎不多花时间;
- 直接给出判断的概率,不用让聊天模型在回答里自己报一个把握程度;
- 不用为每个任务重新训练,改改问题和选项就能换任务。
Jev 针对的痛点是真的,团队履历和接口优势也是真的。但被渠道和资本一轮轮放大之后,最响的那两个数字只在官方的测法下成立,替不了你自己做选型。
下次再碰到「快 100 倍」「零幻觉」「颠覆」这种说法,我会拿下面五个问题挨个问一遍。
第一个问题:它替代的是谁?
看一个新技术,先别问它有多强,先问它要抢谁的活。
Jev 的宣传一直拿自己跟 GPT、Claude 这些前沿大模型比。真接进项目才发现,它瞄准的只是流程里那一小段判断,不是整个大模型。写作、聊天、长链推理,Jev 都做不了。
它抢的,是流程里那些写不成死规则、以前只能交给传统分类模型或大模型的模糊判断。能用 if-else 写死的,还是留给代码更合适。
很多地方用大模型,其实是高射炮打蚊子:只想做一次简单判断,相当于程序里的一个高级 if-else。Jev 抢的就是这块。
那它和传统分类模型又有什么区别?这是我接完 Jev 之后最困惑的问题。我当时的原话是:
我想让它判断一篇面试复盘是否合格,那我就得详细说出来到底什么是合格。那么它跟大模型、或者是原来的 BERT 分类模型,到底是什么区别呢?难道只是因为便宜吗?
后来想清楚了,区别不只在价格,还在于你用什么方式告诉它「什么算对」。
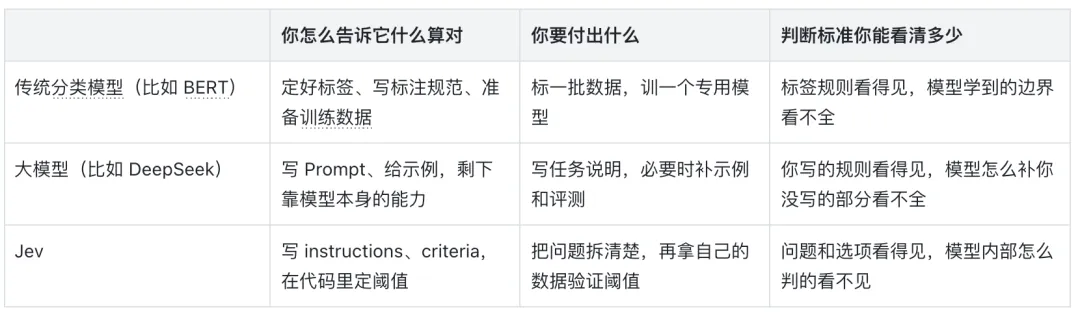
它不用你先训练一个专用分类器,改改问题和选项就能换任务;但真想放心让它自己做决定,还是得拿标注好的样本去验阈值。和普通聊天接口比,它直接给固定类型和概率,一次判断很多题时也更占优势。
但代价是:你必须比以前更清楚,自己到底在判断什么。
第二个问题:宣传的数字,在你的场景里还剩多少?
每一个倍数,都要追问三件事:跟谁比?题是谁出的?换成我的数据还剩多少?
Jev 的 193.6 倍和 444.6 倍,来自 TypeSafe 自己搭的工作流评测,对比对象里有需要先推理的前沿模型;官方自己也说,这组数字在真实收益里偏高。
换到我的项目,我没做同题同输入的对比,只能从两条真实流程的记录里看到:耗时中位数差了 200 毫秒,账单差了几块钱。
倍数不是假的,但它是在别人的考场上考出来的。
第三个问题:它说的「好」,是哪一层的好?
「零幻觉」「校准」「可靠」,听着像在说同一件事,其实管的是完全不同的层面。
官方图里的「零幻觉」,指的是输出不会跑出你定义的选项,不是说业务判断不出错。「校准」说的是一大批预测的统计表现,兜不住单个答案。至于中文,官方只承诺「能处理,但不如英文」。
格式对了,不等于判断对了。一个技术说自己可靠,先问它可靠的是哪一层。
第四个问题:接进来之后,复杂度转移给了谁?
软件工程里有句老话,我一直很认同:
复杂度不会消失,只会转移。
Jev 把模型那一端变简单了:不生成文字,不用解析,不会出类型错误。但省下来的复杂度,有一部分挪到了用它的人身上:
- 题目要按它的格式写,而且一道题只能问一件事;
- 阈值得你自己拿数据去调,还得一道题一道题地调;
- 输出是一堆概率,要接进系统、要给人看,都得你自己再加工。
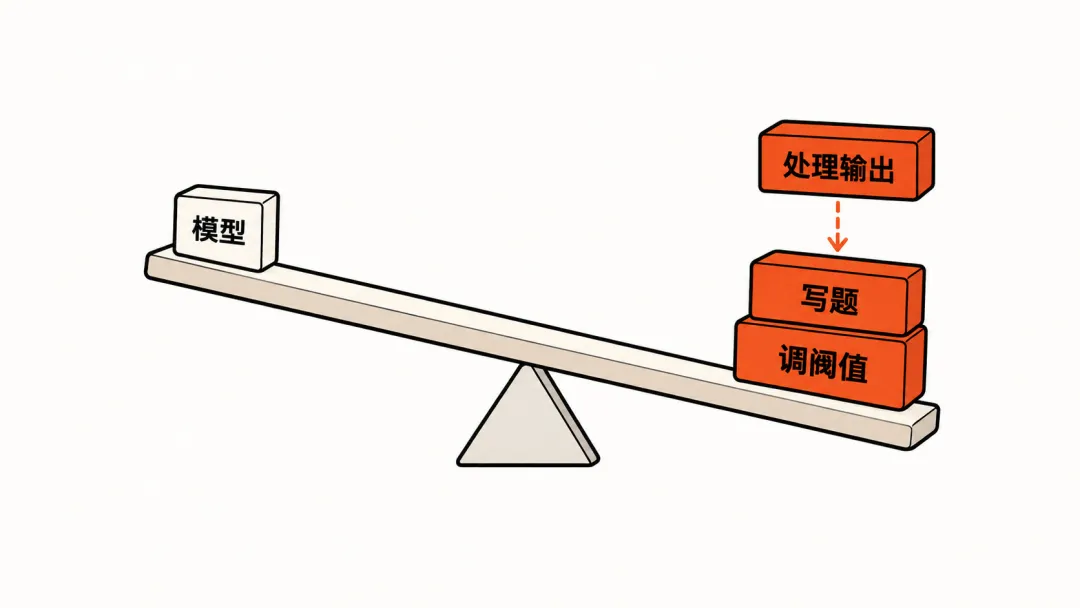
官方写了一百多页文档,教你怎么写题、怎么定阈值,还专门列了九类短板。文档长不能直接说明复杂度转移了,但至少说明,这个模型不是调一次接口就能用对的。
我在项目里感受最深的一点是:我连自己到底在判断什么,都没写清楚。
后来在官方文档里,我读到一句几乎一模一样的话:
It answers the question you wrote, not the one you meant. 它回答的是你写下的问题,不是你心里想问的问题。
后面还有一句:
When you look at a wrong answer and find yourself explaining what you really meant, that explanation is the missing half of the instruction. 当你看着一个错误答案,发现自己在解释「我其实是想问……」,你解释的那段话,就是你的题目里缺的那一半。
通用大模型有时会拿预训练学到的常识,替你把缺的那一半补上,所以你会觉得它更懂你;代价是它按什么标准判的,你更难控制。Jev 则要你自己把缺的标准补回来。
所以我接完 Jev 最直接的感受是:加了一个判断,项目反而更麻烦了。
第五个问题:算总账,值不值?
最后只看总账:省了多少,提升了多少,接入和维护花了多少,判错一次代价多大。
我的审核场景:省下的是几块钱,换来的是一个下午的排查、好几轮改题,审核最后还是得我自己一篇篇看。这笔账,我不想再算下去了。
学员的海龟汤场景正好相反:玩家一局要问几十个问题,每个都得秒回,答案本来就是封闭的。按现在的反馈和我的小样本测试,至少值得继续跑影子测试,也就是先让它在后台陪跑,只记录不生效。
虎嗅上有一篇文章说得很对:
判断错一次要付出什么代价,往往比单次调用省了多少钱更重要。
五个问题,一张表
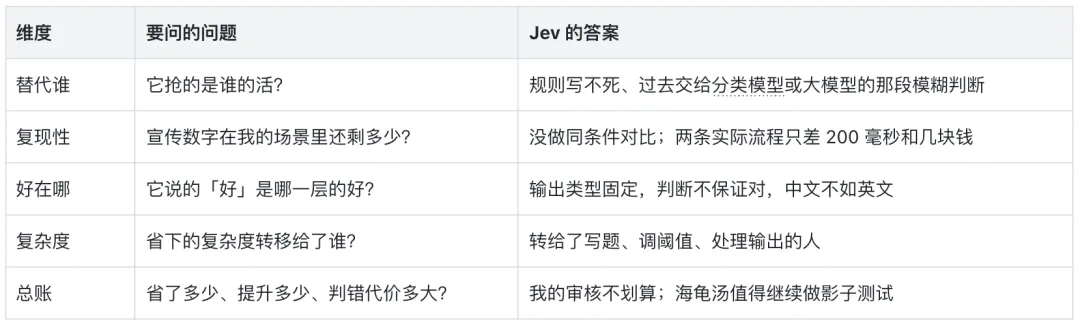
落到使用上,我现在先看一件事:任务有没有放对位置。
判断类的模型适合嵌在项目里,处理流程中间那些又小又多的判断。但能交给 Jev 的只是其中一部分,我的审核就是个反例。
先看一个更适配的例子:海龟汤
在我的审核里,Jev 没跑通。但几天后,学员那边给了我一个完全相反的反馈。
他们在做一个 AI 海龟汤的产品。
海龟汤是一种推理游戏:主持人手里有一个完整的故事,叫汤底;玩家只能通过提问来猜真相,主持人只能回答「是」或者「不是」,有的玩法会再加一个「无关」。
在 AI 海龟汤里,主持人换成了模型。玩家每问一个问题,模型都要对照汤底判断该怎么答。
他们原来用的是 DeepSeek,后来把这一步换成了 Jev。按学员的说法,准确率明显提上来了。不过我没拿到完整日志、样本量和对照条件,所以只把它当成一条正向线索。
海龟汤的回答,本身就是一道封闭的选择题,几乎就是 Jev 的出厂设定。
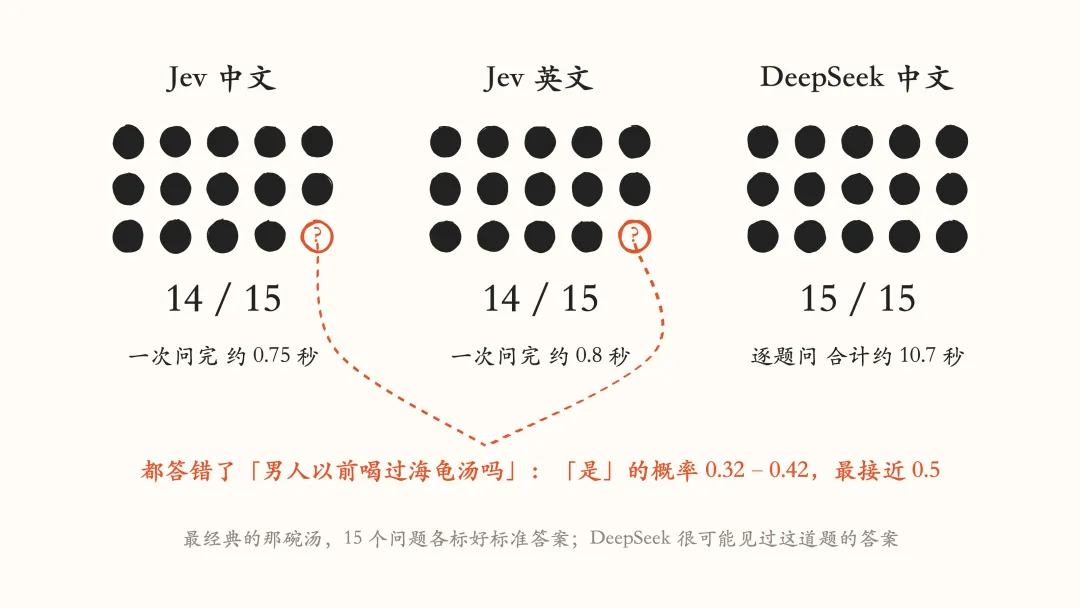
我自己也拿最经典的那碗汤试了试:一个男人在餐厅喝了一口海龟汤,回家就自杀了。我准备了 15 个玩家可能问的问题,每题标好标准答案,中文、英文各问一遍,再让 DeepSeek 当主持人对比。
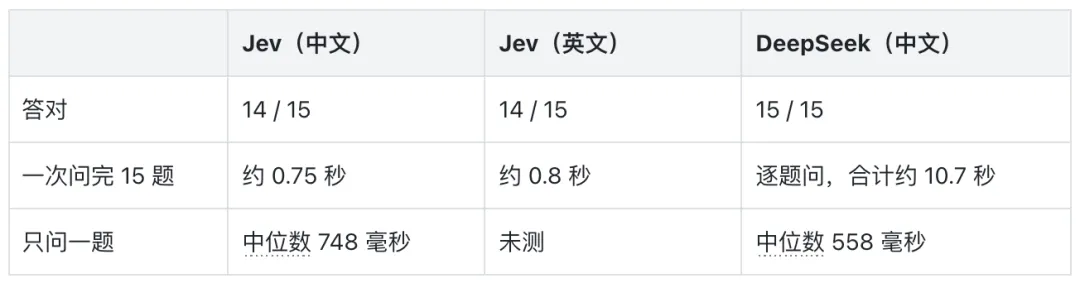
这两个批量耗时没法直接比,Jev 是一次问完 15 题,DeepSeek 是一题一题调的,只能说明放进这个玩法后,玩家实际要等多久。
先看语言。15 道题的中英文答案完全一样,区别在概率集不集中。比如「服务员骗了他吗」,英文「是」的概率是 0.95,中文是 0.62 到 0.77。在这组题里,中文能答对,只是没有英文那么笃定。
Jev 唯一答错的,是「男人以前喝过海龟汤吗」。标准答案是「是」,它说「不是」。可他当年喝的根本不是海龟汤,是被骗的。这道题本身就有争议,很多主持人会答「是也不是」。这题「是」的概率在 0.32 到 0.42,最接近 0.5,是 15 题里它最犹豫的一题。它没答对,但至少把自己的犹豫暴露了出来。
再看 DeepSeek。15 题全对,但这碗汤太经典,大模型很可能早就背过答案。延迟是在我的网络环境下测的,要过代理和中转平台:单问一题,Jev 并不比 DeepSeek 快,成本也差不多,单题都在 0.00003 美元上下。
学员用的是自己编的汤,没有现成答案可背。我猜在这类材料上,Jev 稳定的输出,还有它拿不准时给出的低分,可能更有用。要把这个猜测变成结论,还得拿自编汤、统一输入和标准答案做一轮对照测试。
把两个场景放在一起看:
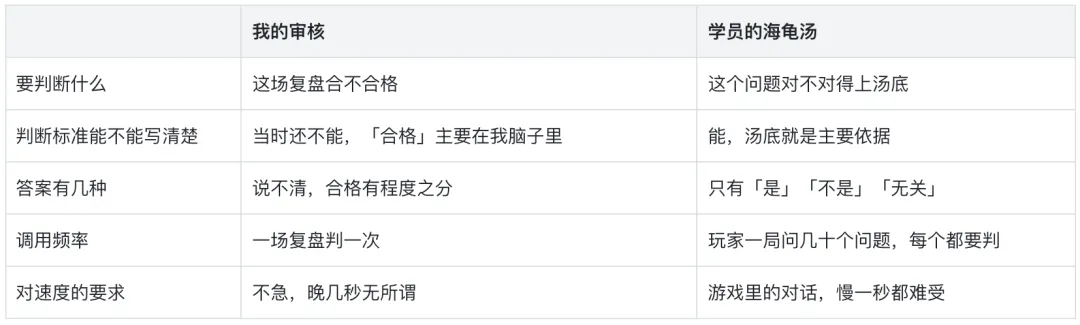
海龟汤最适合 Jev 的是前两条:答案封闭,标准现成。速度上的优势,得直连官方接口才可能拉开。
适合它的场景,长什么样
把海龟汤和我的审核放在一起,我会先问两件事:判断标准能不能写成规则,答案能不能穷举。这两件事都说不清,模型再便宜也不该先把决定权交给它。
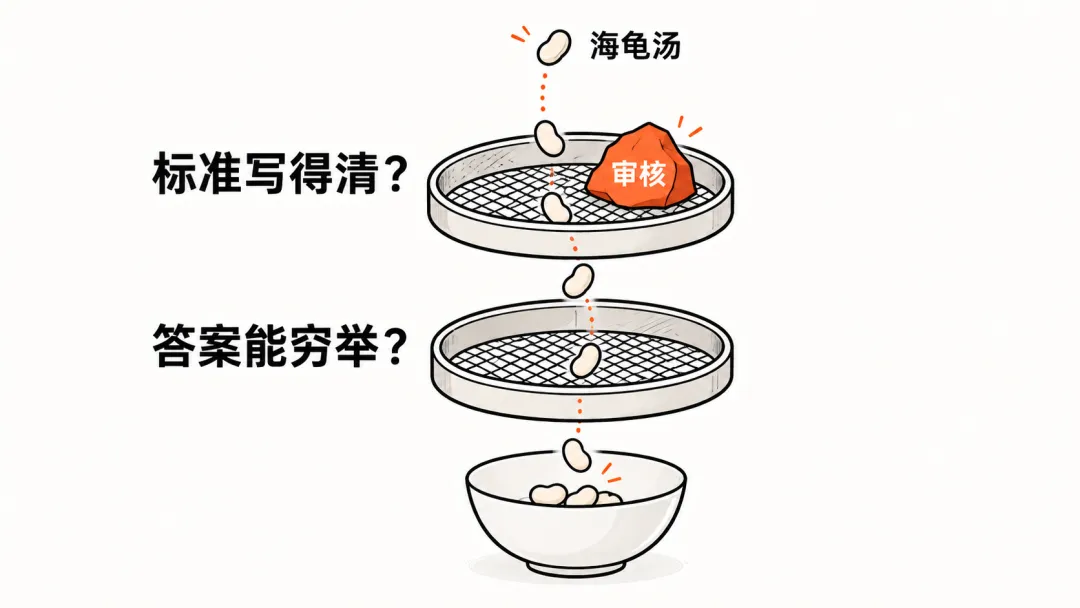
然后才看调用量和速度。按我这次的账单,两万五千多次也只省了几块钱,如果省下的钱抵不过接入和维护的成本,调用再便宜也没意义。海龟汤不一样,玩家就在那等着回答,几百毫秒和几秒是完全不同的体验。
这几个条件越齐,越值得先做影子测试;还拿不准,就先拿一小批真实数据跑着看,再决定要不要跟规则或大模型搭着用。
官方案例列了六类场景,下面挑最常见的四类。数字都是官方在英文数据上自测的,看个方向就行:
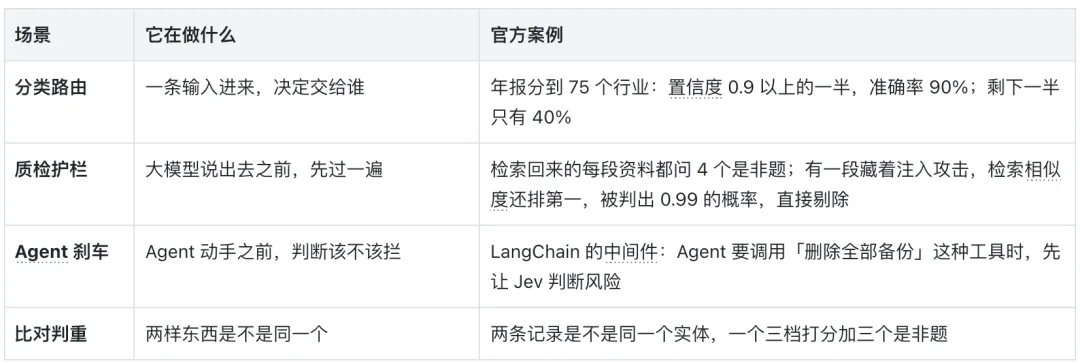
这些场景里,Jev 几乎都不是单独干活的。前面有规则或检索帮它缩小范围,后面有代码、大模型或人给它兜底。
中文的真实业务里,我目前只在自己的判重和这次海龟汤测试里看到了正向信号,还谈不上准确率有保证。所以其他场景我会试,但不会拿官方案例替自己做决定。
真要用,记住这几条
- 一道题只问一件事。 塞三个条件,就会出现我那种「三个都满足才给高分」的情况。
- 让高分代表「是」。 别问「没有个人信息吗」,问「有个人信息吗」,再在代码里取反。
- 打分题写情境,不写程度。 模型看不到档位编号,「比上一档更严重」对它来说毫无意义。
- 阈值按题调,用自己的数据调。 拿一批标注好的数据,对照模型打的分和真实对错,找到够用的那条线。校准是按题做的,不是按模型做的。
- 换了题型、换了模型版本,阈值都要重调。 是非题上调好的线,别直接搬到选择题上。
- 别让它单干。 验证过、足够确定的结果才自动执行,中间地带交给大模型或人复核。创始人自己的说法是:If it's in the middle, then you do the next bigger model.(拿不准的,就交给更大的模型。)
- 先影子运行,再放权。 先只记录、不生效,对比的数据够了再交权。
别拿它做什么
官方专门有一页文档讲 Jev 的短板,我把原文和绕开的办法放在一起:
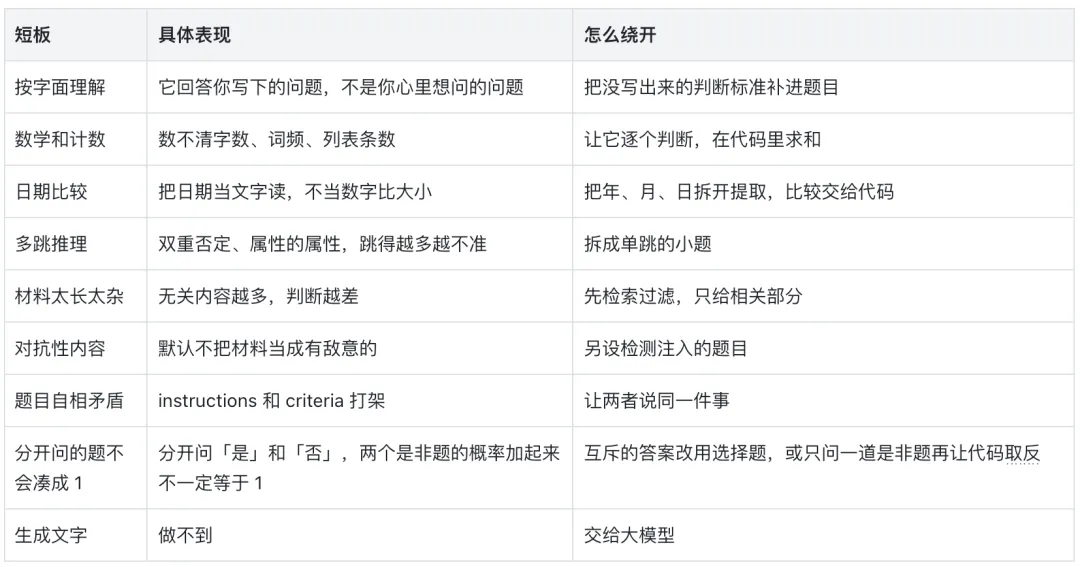
中文用户还要多看一眼。硅星人做过一个测试(虎嗅转载):50 道中文客服判断题,每题要判紧急程度、是不是售前、处理类别、严重程度四项,四项全对才算这题对。
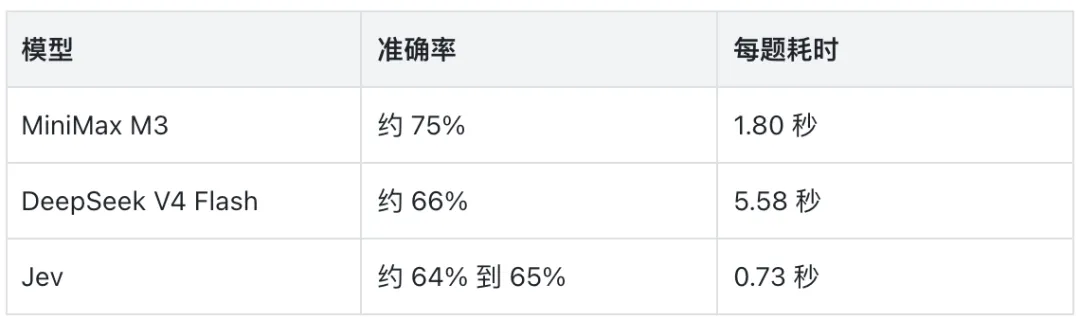
而且 15 次重复测试里,有 3 道题的结果在对和错之间来回跳。
Jev 适合当流水线上的质检员,不适合当拍板的主管。
面试的时候该如何去说 Jev,面试官未必会主动问 Jev,更可能问:一个新技术突然爆火,你怎么把它测到足以做决定。我会按事情真实发生的顺序讲:为什么测、放进了什么场景、哪里失败了、怎么排查的,最后为什么一边撤、一边留。
一段示范回答
如果面试官问:「最近有没有研究过什么新技术?」可以这么讲:
最近 Jev 很火,我没停留在看测评上,直接把它接进了自己在做的产品里。我想用它做两件事:面试题判重,和面试复盘的自动审核。
做法上,我照着官方材料里的例子,把阈值定成三档:0.9 以上自动通过,0.5 到 0.9 转人工,0.5 以下判否,然后拿 30 场真实数据试跑。
结果是,判重里的同义题多次给到 0.93 左右,我先把它留在流程里接着跑;但审核这边,30 场没有一场达到 0.9,全部转人工。我排查下来有两层原因:一是接法上,我把三个条件塞进了一道题;二是换成只问一件事以后,这批材料的分数还是集中在 0.4 到 0.55,说明任务和阈值都还没调到能自动放行的程度。成本上,两万五千多次判重,实际账单只差了几块钱。
我的判断是:Jev 更适合标准能写清、选项封闭、高频、要求快的判断。至少不适合我当时那套连「合格」都没定义清楚的审核流程。
最后我的决策是:判重留给 Jev,审核换成 DeepSeek,再叠一层规则和人工一键确认。不同的场景用不同的模型,这本来就是产品经理该决定的事。
这段话不到两分钟。数字记不全没关系,最后那个决策一定要讲清楚:我把它撤了,而且说得出为什么。
接住追问
讲完之后,面试官很可能接着追问。下面三个问题,我会提前准备好:
- 「阈值为什么定 0.9?」 一开始是照着官方材料里的例子定的,这恰恰是我犯的第一个错。阈值应该用自己的数据按题去调,不能照搬。
- 「为什么不直接把阈值降下来?」 不能拍脑袋降。我后来用自己造的数据复测过,真实面试风格的材料是 0.54,备考题库是 0.30,排序是对的,说明按题调阈值有可能行得通。但前提是手里有一批标注好的真实数据,画出分布,找到能把两边分开的那条线。我当时没有这批数据,就没法证明降了阈值还安全,所以换成了规则加大模型。
- 「那 Jev 到底有没有用?」 有。我的判重还在跑;海龟汤只给出了正向信号,下一步还是影子测试。
两个误区
- 不用每个新技术都追。 我现在更愿意只追一个,追到能做决定为止。面试官更在意的,也是你有没有把其中一个钻深。
- 接过一遍,不等于研究过。 没有数据、没有排查,也没有最后的取舍,那只能算试用了一次。
Jev 到底哪里牛?
它把一类判断做得很窄:快、便宜,输出永远落在你定义好的选项里。
它还没证明的,是革命、颠覆,或者让业务判断不再出错。
现在,我的判重还在跑 Jev,审核交给了规则、DeepSeek 和人工确认。它没有接管整个流程,只留在了最适合它的那一段判断上。
下次再有新模型刷屏,我还是先拿这五个问题挨个量一遍,看它放进我的流程后还剩什么。
附录:给想深挖的人,Jev 的原理推测和示意代码
官方没有公开架构。下面不是在复现 Jev,只是借社区里常见的一种思路,解释固定选项、RLCD 和并行输出这几样东西可能怎么拼到一起。
第一步,假设理解文字的还是语言模型。 前面负责读懂材料,后面再把输出收窄。
第二步,把自由生成改成给固定选项打分。 普通语言模型的最后一层,会给词表里每个 token 打分,再挑出下一个 token。
社区复刻的做法,通常是不让模型接着往下写,只读出候选选项对应的那几个分数,再重新算成概率。原来要在整本词表里挑下一个字,现在只在 A、B、C 里比。
这个思路,用一个开源小模型就能粗糙地演示出来:
# 示意代码:演示单 token 选项怎样直接比较分数,不是 Jev 复现

prompt = 材料 + 问题 + "\nA. 是 \nB. 不是 \nC. 无关 \n 答案:"
inputs = tokenizer (prompt, return_tensors="pt")
logits = model (**inputs).logits [0, -1] # 模型对「下一个 token」的打分
options = ["A", "B", "C"]
encoded = [tokenizer.encode (o, add_special_tokens=False) for o in options]
assert all (len (token_ids) == 1 for token_ids in encoded) # 只支持单 token 选项
ids = [token_ids [0] for token_ids in encoded]
probs = logits [ids].softmax (-1) # 只看这三个选项的分数,重新归一化成概率
整本词表十几万个候选,这段代码只取三个选项对应的 token,其余全扔掉,所以答案不可能跑出这三个选项。但它只适用于每个选项刚好是一个 token 的情况,选项更长的话,得算整段的得分。这只是在演示社区的猜法,复现不了 Jev。
第三步,用 RLCD 优化判断。 官方只确认这种训练方法是面向校准决策的,具体训练哪一块,没有公开。
第四步,让多道题并行。 先看普通大模型怎么提速:
# 普通大模型:把一次对话里的三个问题,拆成三次请求同时发

results = await asyncio.gather (
llm.ask (材料,"该给哪个团队?"),
llm.ask (材料,"客户有多生气?"),
llm.ask (材料,"紧急吗?"),
)
这样确实能并发,但端到端能快多少,要看请求、模型和服务端,不能直接算成三倍。而且同一份材料要重复发三遍,输入成本也跟着重复算。
官方能确认的是:多道题会针对同一份材料并行、独立地评估,多加题目几乎不增加响应时间。材料是不是只读一遍、有没有共享 KV cache,官方没说。最多只能猜,它复用了某种对材料的中间表示,再让多道题并行打分。
除此之外还有别的猜法。Diogo 在播客里说过「弗兰肯斯坦式地把它们拼在一起」,有人据此推测它是用多个预训练模型拼装改造出来的;也有人猜它是产品化的奖励模型,或者跟扩散模型类似。
复制本文链接 文章为作者独立观点不代表优设网立场,未经允许不得转载。
小普

130.7w人气 45文章
发评论!每天赢奖品
点击 登录 后,在评论区留言,系统会随机派送奖品
2012年成立至今,是国内备受欢迎的设计师平台,提供奖品赞助 联系我们
用户体验增长
已累计诞生 795 位幸运星
发表评论
↓ 下方为您推荐了一些精彩有趣的文章热评 ↓