以往学 AI 视频生成流程繁琐。收藏提示词、开工具调参数、导出发布,来回切换。抖音把整套搬进了「拍同款」。
语音输入转文字虽然方便,但是我们说话的时候经常会夹杂着语气词或者重复内容,给阅读者带来不便。微信输入法最近上线的这个语音智能整理功能,不仅能自动过滤废话,还能把一段碎碎念直接...
靠提示词控制AI生成视频的镜头很难的,有位网友Reid Hannaford想了个奇招,直接把 Blender 里的粗糙低模视频作为 Seedance 2.0 的结构和运动参考...
华为天气中根据气候推荐的穿搭图片是AI生成的,这不新鲜,小巧思来了,根据这些穿搭图片和天气让AI基于你的情况,生成新的个性化专属穿搭图片。让「穿衣建议」不再是一个死板的功能,...
生成视频要精细控制动作很难,用文字表述经常出现意外,就算是先生成图片做参考,也会出现失误。LibTV最近做了个导演台的功能就很好解决这个问题。在可以先在 3D 空间里像摆积木...
做AI视频生成想让画面里的主角从面无表情变成微微一笑,整张图重绘一次就把背景和构图全毁了。LibTV推出的情绪控制功能,在把「局部重绘」和「情绪微调」直接打包成了一个极其傻瓜...
以前照片拍完以后,构图基本就定死了。你最多裁一裁、调一调颜色。iOS27的空间重构功能,AI会去理解照片里的空间结构,推演出画面周围可能存在的环境。
基于版权和反诈考虑。Seedance模型不能上传真人视频做参考。如果只是想把参考视频的动作该怎么办呢?
在腾讯混元的图片生成时,当你想要对刚产出的图片进行二次调整(如局部重绘或风格延续)时,无需手动下载并重新上传。系统在图片下方提供了一个「重新填入对话框」的快捷入口,点击后,图...
对于一些动作系视频来说,如果你生成多张图片的分镜,不仅自己看起来没有连续感,AI可能在生成的时候也很难处理分镜之间的流畅过渡。网友Larus Canus想到了一个绝妙的AI视...
为了制作一个几十秒的流畅长镜头,设计师们往往要在剪辑软件里反复调试运镜参数,一帧一帧地处理过渡效果。如果用AI呢?很多视频AI只能上传2张图转视频。
最近经常看到大家吐槽,AI生成的短剧人脸都一个样。LibTV推出的虚拟角色库提供了一批现成的高质感数字演员,全部是真实质感风格,形象稳定可控,一键调用就能直接投入生产,省去反...
字节的Seedance2.0是公认的最强视频生成大模型,不过字节并未就此止步,刚刚有上线了4K画质和10bit色深的选项,这对专业影视工作者来说很有意义,后期剪辑有更多调整空...
AI 生成的文字很容易看出来有 AI 味。即使你花了很多提示词、Skill 去调教,还是更容易和别人用 AI 生成的内容重合。 OpenAI这次在ChatGPT里推的新功...
用户通过AI拿到了想要的答案,然后呢?对话戛然而止,用户随手就关掉了App。我们绞尽脑汁地在界面上添加「猜你想问」、「相关推荐」等模块,但点击率总是不尽如人意。
气象图表对绝大多数普通用户来说门槛太高。大部分人看到几级风圈、热带低压和复杂线条时,很难直观判断自己所在的位置到底什么时候受影响、影响多严重。华为天气的AI Agent会自动...
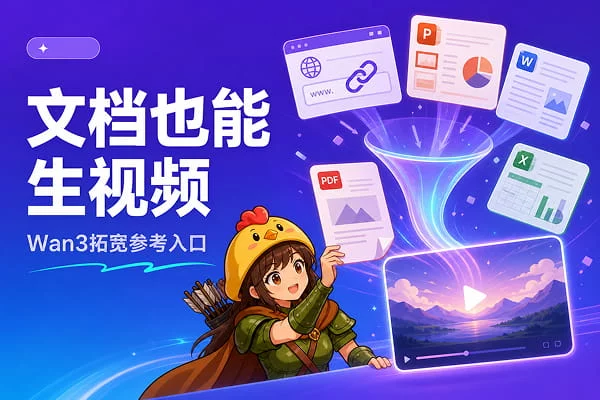
以前聊 AI 生成视频,大家的直觉无非是文生视频、图生视频,或者丢一段音视频做风格迁移。阿里的 Wan 3.0 这次把参考素材的范围直接拉宽到了网址、PPT、Word、PDF...
Typeless 重新定义了语音输入法。按下Command键就开始录音识别,它并不只是把你说的话转成文字这么简单,而是通过对原始语音用AI进行深度的语义修剪,将充满口癖、重复...
提问和回答是知乎的核心功能,很多精彩的回答非常干货,看完之后感觉学到好多,意犹未尽。还想再扩展学习更多相关的知识。现在知乎有了一个巧妙的解决方案:在优质回答底部,AI会自动生...
为了完成一个数据报告,你需要在好几个软件之间来回切换,一边整理数据、一边制作图表,最后还要吭哧吭哧地把它们整合到幻灯片里。整个过程繁琐、耗时,而且极易出错。如果有一个「数字员...