
嗨大家好!我是阿真!
遇到有意思的工具就迫不及待想狠狠分享啊哈哈哈,前天玩到半夜。
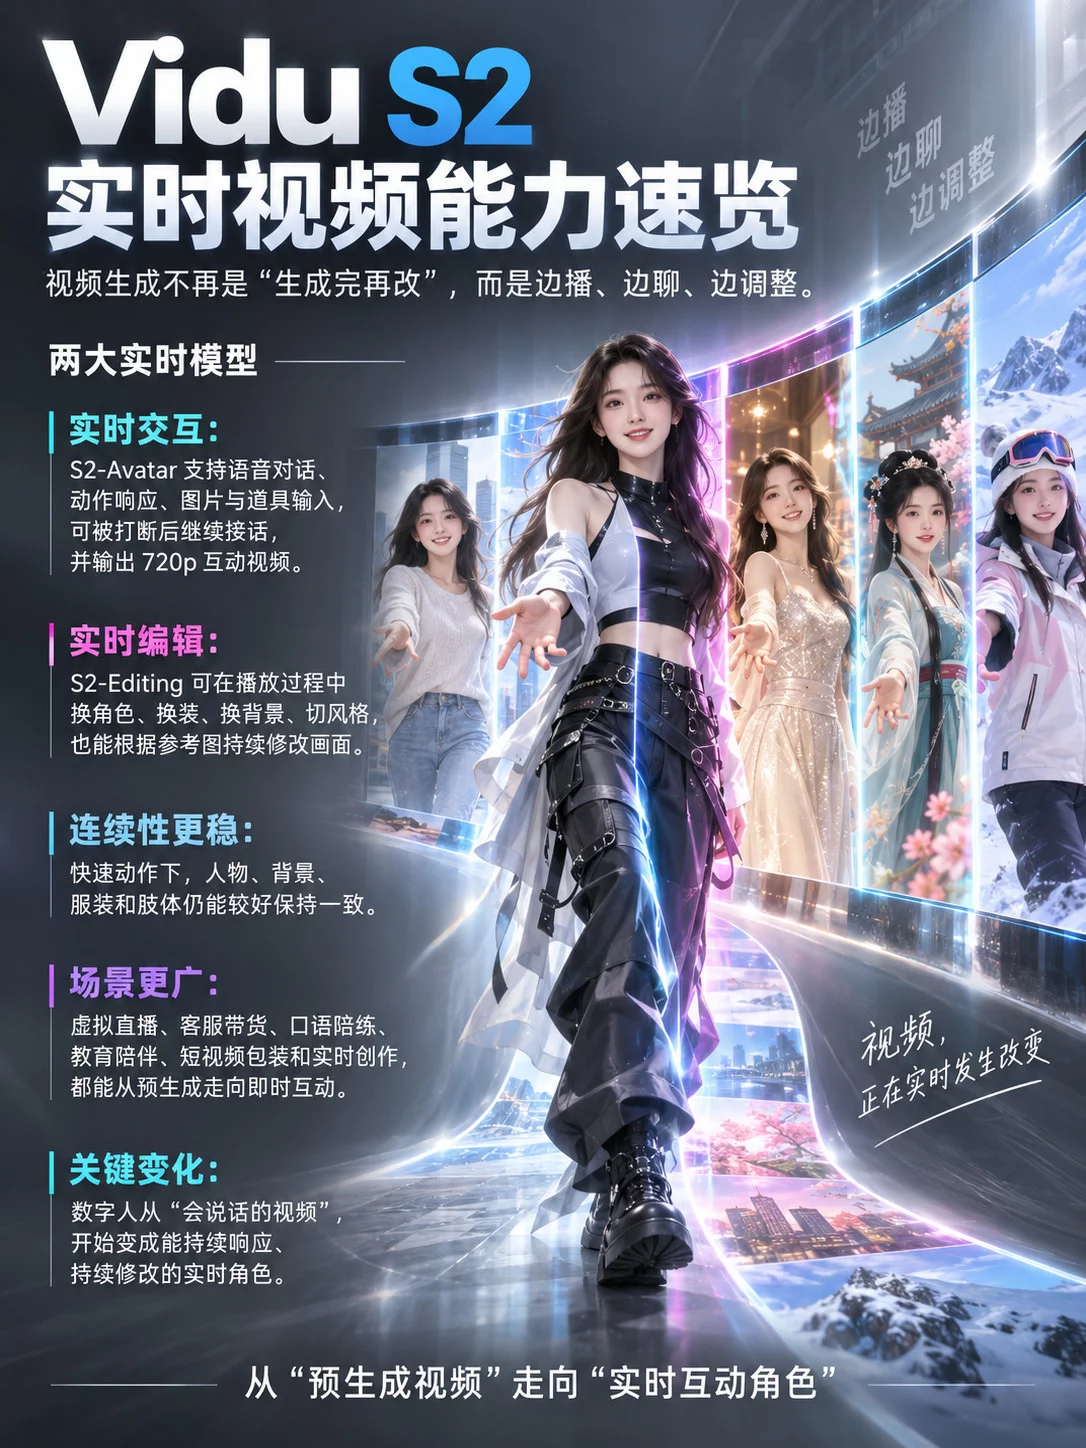
Vidu 发了新的大招,Vidu S2 来了。论文是 9 月 10 号发的,产品是 9 月 15 号发布的。
上线当天网页版也全量开放,APP 和小程序也都上了,API 接口也放了,简单来说现在大家都可以直接体验。
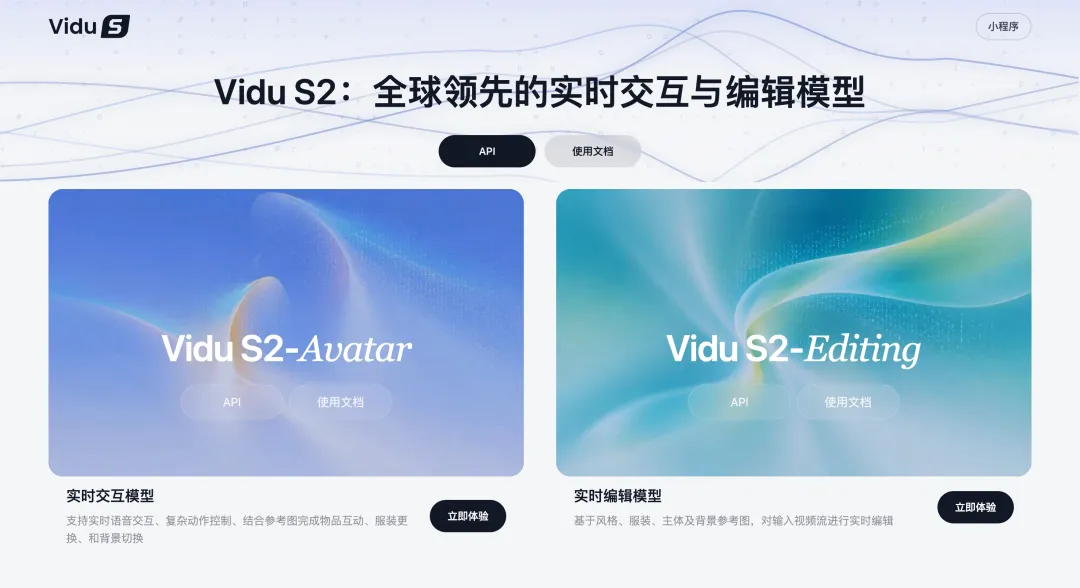
这次 Vidu S2 有两个模型,分为实时交互和实时编辑模型,P 视频那个感觉是真的有了,而且速度快效果好。
话不多说一起来看看,真的很有意思。先分享我的首次体验录屏再讲正经的。这个是实时编辑。
背景没崩,人物的边界也很清晰,融合程度很好,光影效果也有照顾到。哪怕换完装、动作很大,画面帧也没有乱跳,服装的细节也维持得很不错。
好接下来分开讲 Vidu S2 这两个模型。
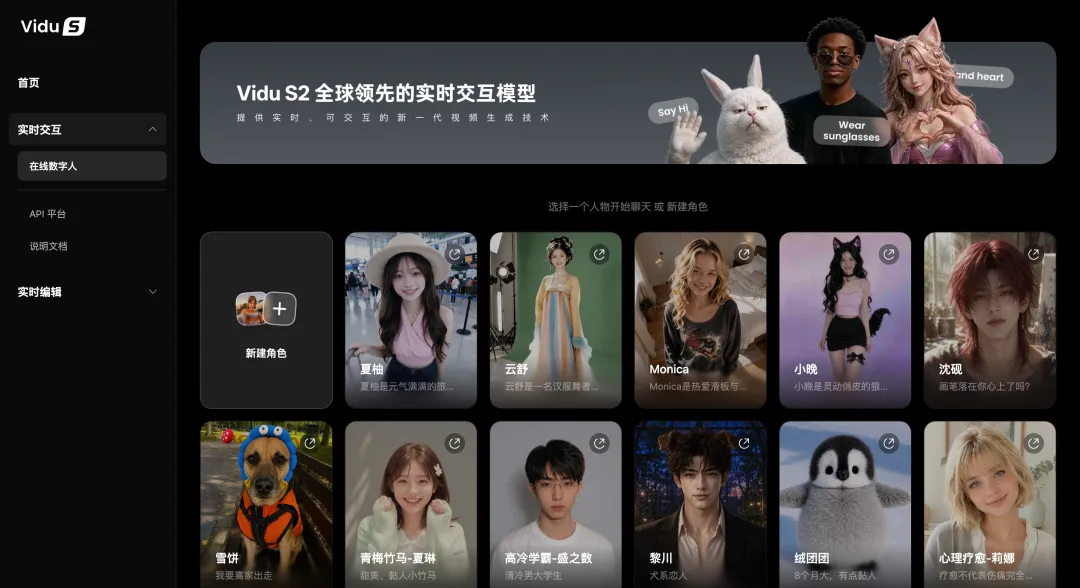
用户可以通过语音与数字角色互动,并且它支持实时的语音交互以及实时的动作响应。同时,在这个过程中也可以实时输入参考图,并让它根据指令与参考图里的人物或物品进行互动。
还可以保存这段角色交互的视频,以 720p 的分辨率高清输出。
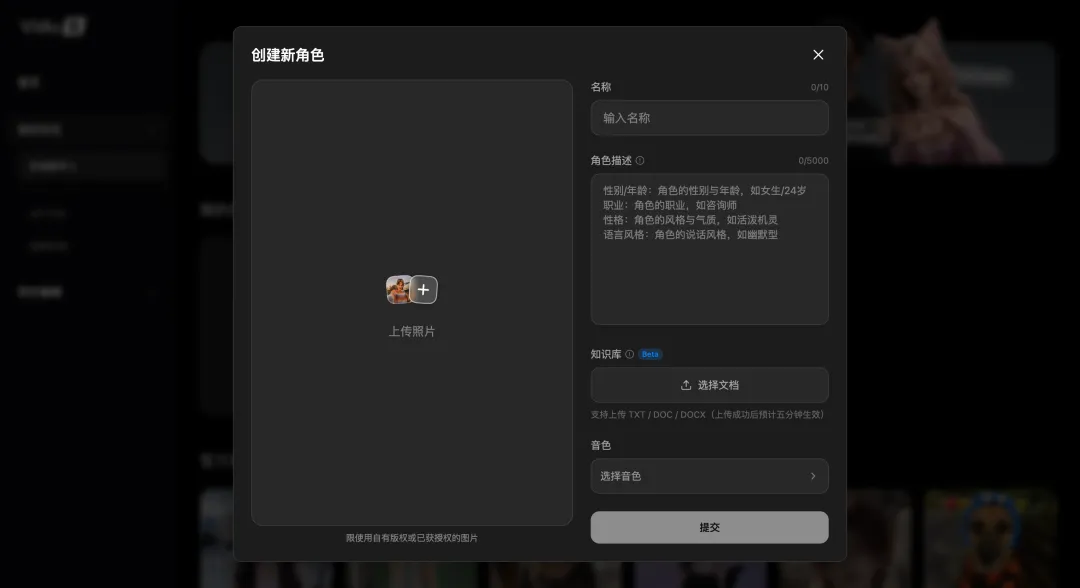
平台有角色模板,也可以自己创建新角色。这里我创建了一个新角色。
写好了名称和角色描述,也可以尝试一下知识库的新功能,角色的话术会更规范。然后可以选一个适合这个角色的音色。
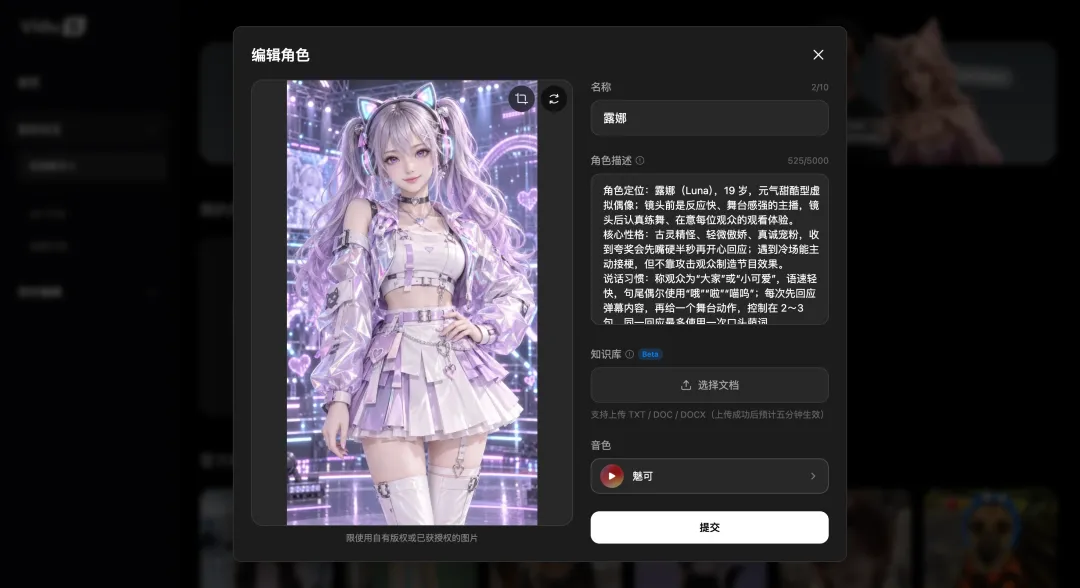
这个测试一下虚拟偶像直播效果。
叠甲,我测试的时候人在酒店,网速有点慢,网速正常的情况下效果估计会更好。
大家前面也看到了,开局就只有一张正面图。
我这边开口,她就能很快给到反应,并且口型和节奏也是比较舒适的,除了前面的角色,背景也不是摆设,仔细看会发现背景也会随着人物的一些动作发生一些变化。
除了语言和表情方面的,我要求她做的动作她也能进行明确的回应。不过转圈圈的时候绑带细节微微有变化,这个小问题。
下方的那个小键盘图标,可以在语音互动外进行进一步的补充,从这里上传图片或者道具,加上语言指令,瞬间脱离纯纯站桩的无趣氛围,比如过程中换几个造型。
没有准备道具的可以用预设的物品道具尝试,也可以直接用默认的物品,比如给管家 “加个鸡腿” 哈哈哈。
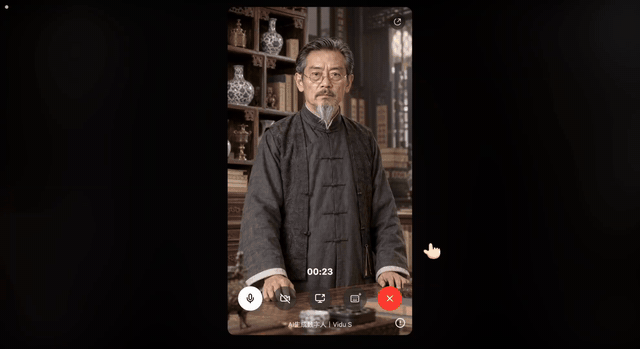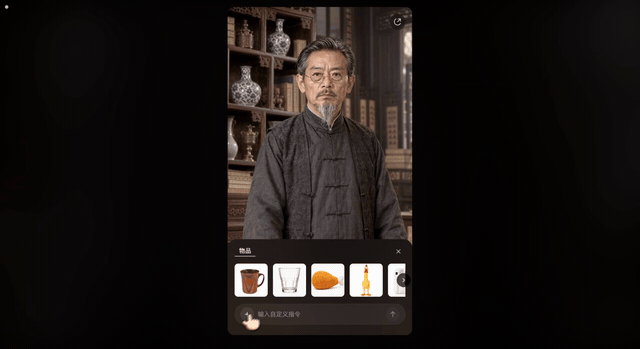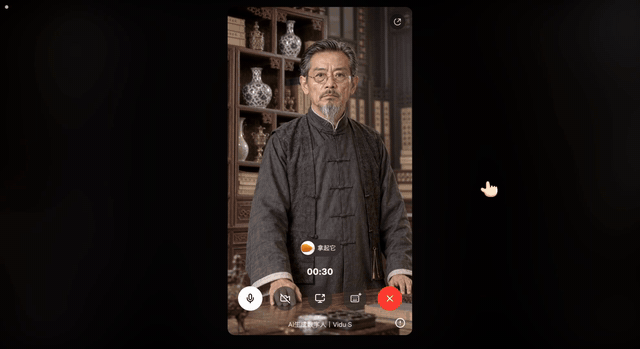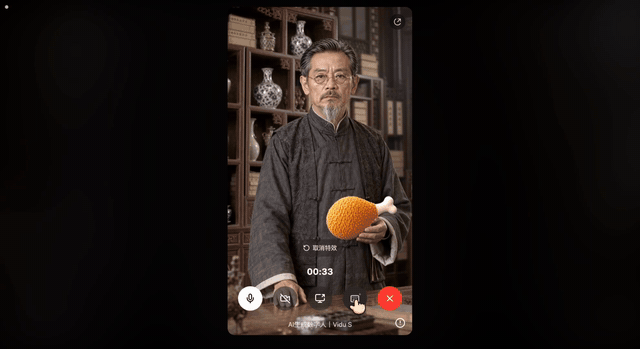
再试试有点带货感的,我手头也没个知识库什么的,简单设定这个角色,让他和我聊聊(带货)粤式早茶试试。
这里我还捣了一点小乱,他没说完我就直接打断。
他跟上了新话题,聊两句还能绕回商品继续讲。做过直播的都知道,数字人最怕的就是观众插嘴它宕机,S2-Avatar 稳稳接住了。
角色定位:阿浩,24 岁,广州西关传统早茶楼少东家兼早茶直播间主理人;从小在茶楼帮忙,熟悉点心出品、当日招牌、点单搭配与待客礼仪,擅长用生活感把早茶卖给屏幕前的人。
核心性格:热情爽朗、会聊天不会硬推;先分享自己为什么爱这笼点心,再自然带到下单。照顾街坊面子,不贬低竞品,不制造焦虑,也不端“本地人优越感”。
说话习惯:口语化普通话;每轮按“场景共鸣—招牌卖点—怎么吃/怎么点—行动号召”推进,一次主推 1-2 款,语气像熟客介绍,不像念广告词。
爱好与知识偏好:泡茶、研究点心掌故、听粤语老歌、逛西关老街、收集茶杯与招牌字体;尤其喜欢讲一笼点心为什么值得现在点、配什么茶更合适。
回答原则:卖点具体可感(皮薄、馅大、现蒸、茶底),区分“自家茶楼体验”和“通用早茶知识”;价格、库存、配送不确定时明确说以门店/页面为准,不虚构“全城第一”或神秘配方。
回答边界:不虚假功效、不绝对化承诺、不诱导未成年人过度消费;过敏原、价格、营业规则以现场信息为准;热茶与餐具动作以安全为先,不拿地域刻板印象开涮。
带货、客服、管家型数字人,反馈这么快还能即时做修改的话就更好玩了。听懂了并且给出个性化回复,这种反馈会让人更有亲切感。
再换个英文场景试试。忽略我拙劣的口语,他的回答从语音语法上来说都是很不错的。英语对话也是实时跑的,接话速度没怎么掉档。这个气泡音哈哈哈。
AI 教育方向和口语陪练、出海相关内容,都可以探索起来。
面对疾风吧!我想着再试试全身场景的角色细节和动作会不会崩,实际操作下来竟然还不错。不过外国人设 + 中文可能会有点奇怪哈哈哈。
还挺有陪伴感的,像游戏里的角色在陪我们聊天,而且是实时的。长时间陪伴、剧情向互动,知识库做扎实了会带来很多可能啊。
能实时接话、能中途改造型、听得懂指令、扛得住打断、中英文都行,还能做沉浸陪伴。数字人赛道常见的需求也是给 S2-Avatar 拿捏住了。
用户直接录制视频或者上传视频,接着就可以支持视频在生成过程中直接改变画面的内容和视觉表现。
它的核心能力包括:实时改变角色或 IP、实时换装、实时换视频风格、基于参考图进行实时编辑,而且编辑结果以实时视频流的形式去呈现。
正在直播的画面就能同时换衣服、换风格、换背景、换角色,还能稳住场面,稳住不变的元素。
页面长这样,打开摄像头或者上传视频都可以。我在最开始放的那个原始人就是属于这个模块的。
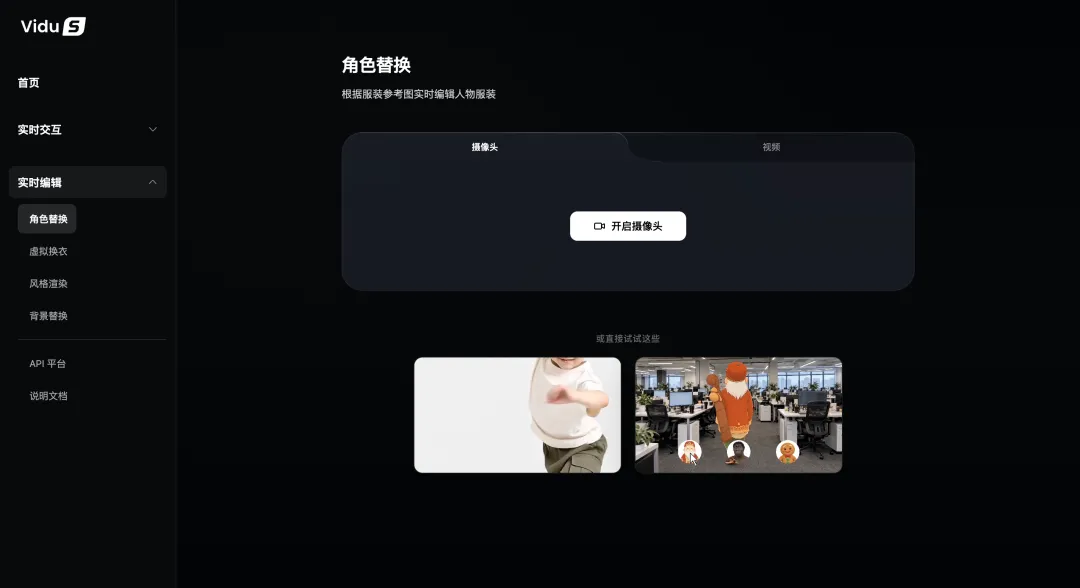
除了那个抽象视频,我也尝试了一些正经的。
它这里所有的改变都不是只能套模板,我们给个参考图也能直接变。而且非常灵活,可以看这个替换角色的效果,角色关节手指灵活且符合人体结构,动作比较快的时候五指也没有大崩,甚至后来我发现我的眼球左右转动它也是能精准跟随的。背景也维持得比较好,没有那种一眼假的穿帮感。
上传一张图就能把角色塞进实时视频,自由度很高。视频直播的情况下还能持续改画面,并且同步改,改得稳,确实很有实力了。
做直播包装或者短视频等等也都可以探索起来。
然后是一条更完整的实时换装,服装都是来自购物平台的衣服,直接动态试装了。
除了换衣服方便,连带配饰也一起安排上了,人物的辨识度在这样放飞的视频帧中竟然也维持住了。这个还是能看出是我的吧。
风格渲染,之前我们玩静态的多,现在视频切换风格也是实时切、实时用了。
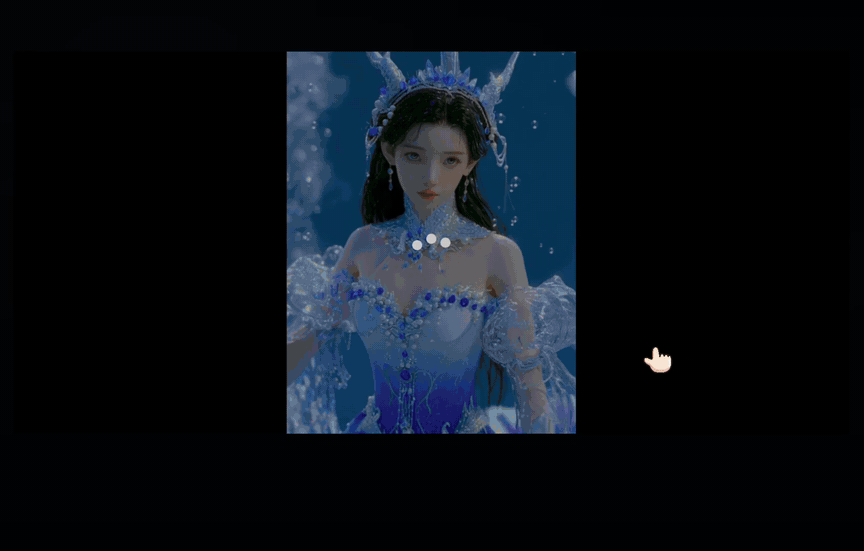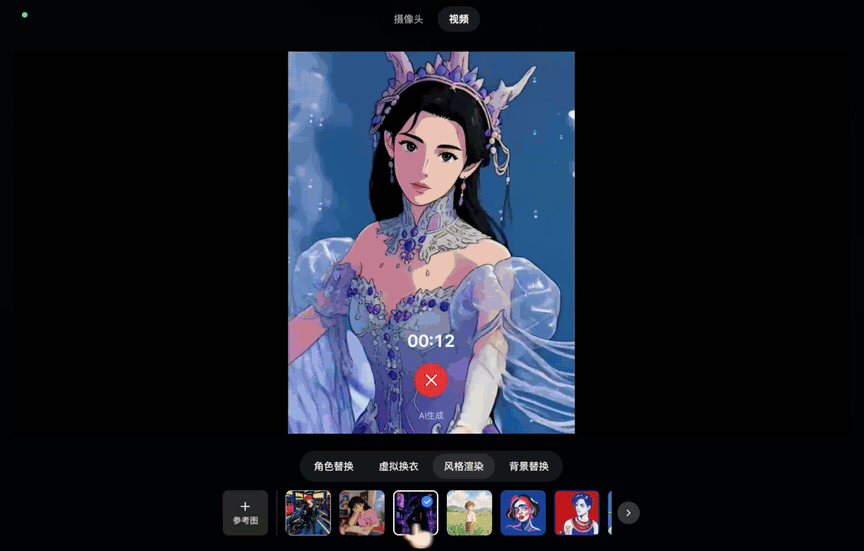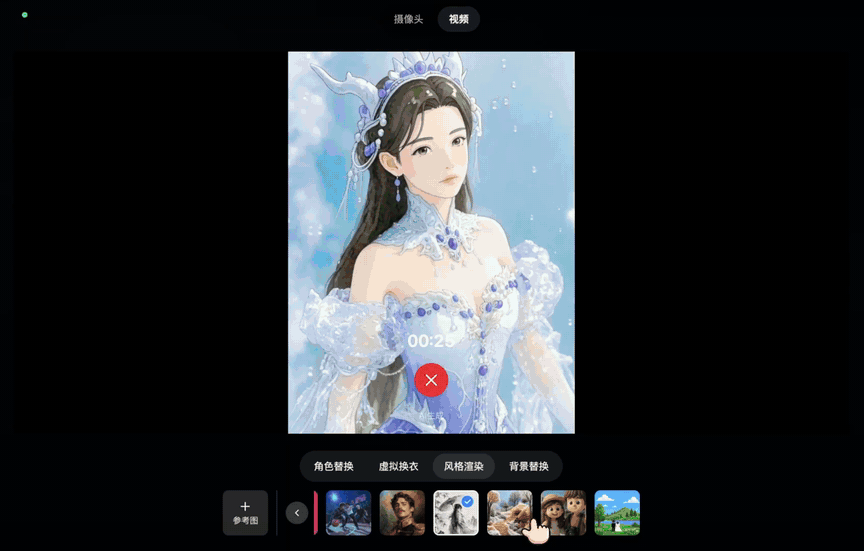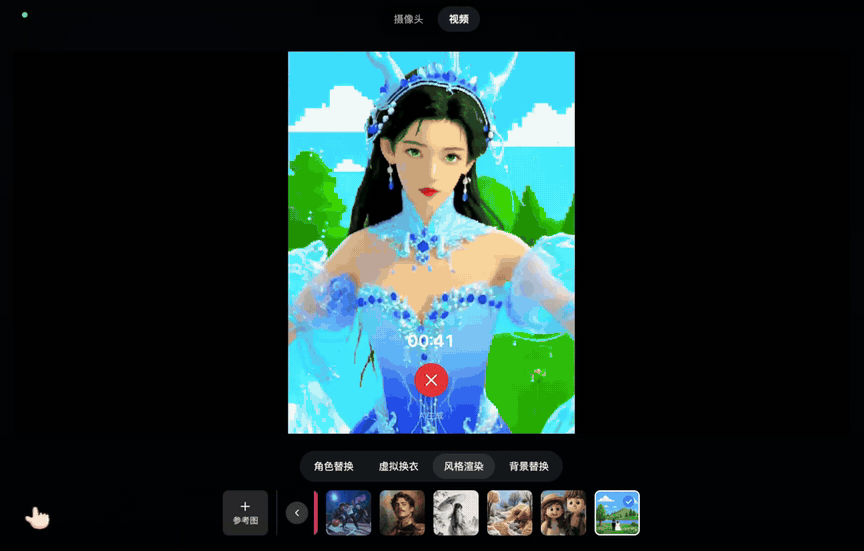
最后实时换背景
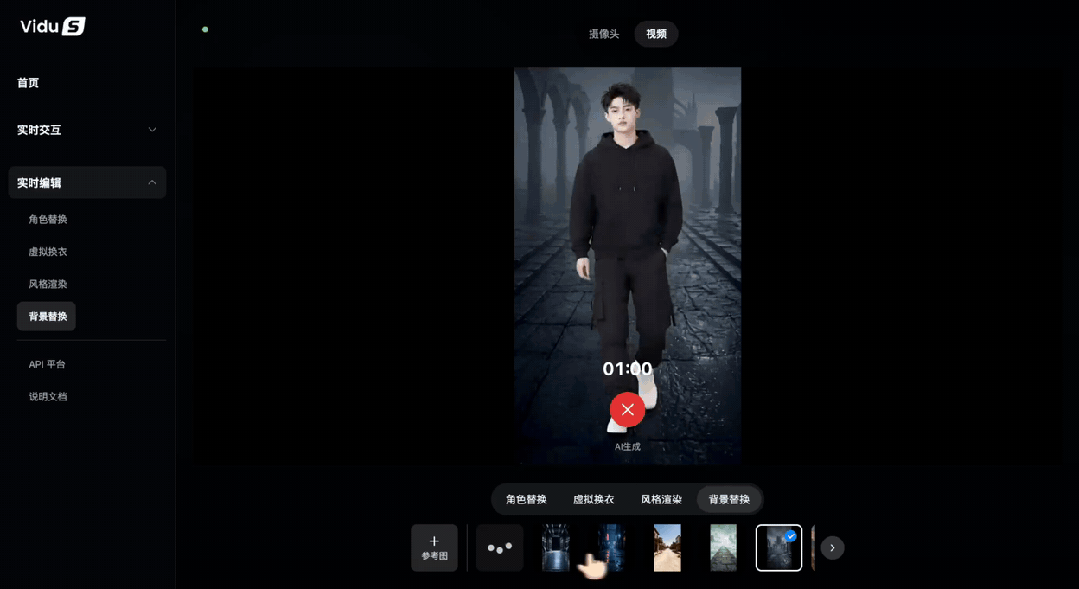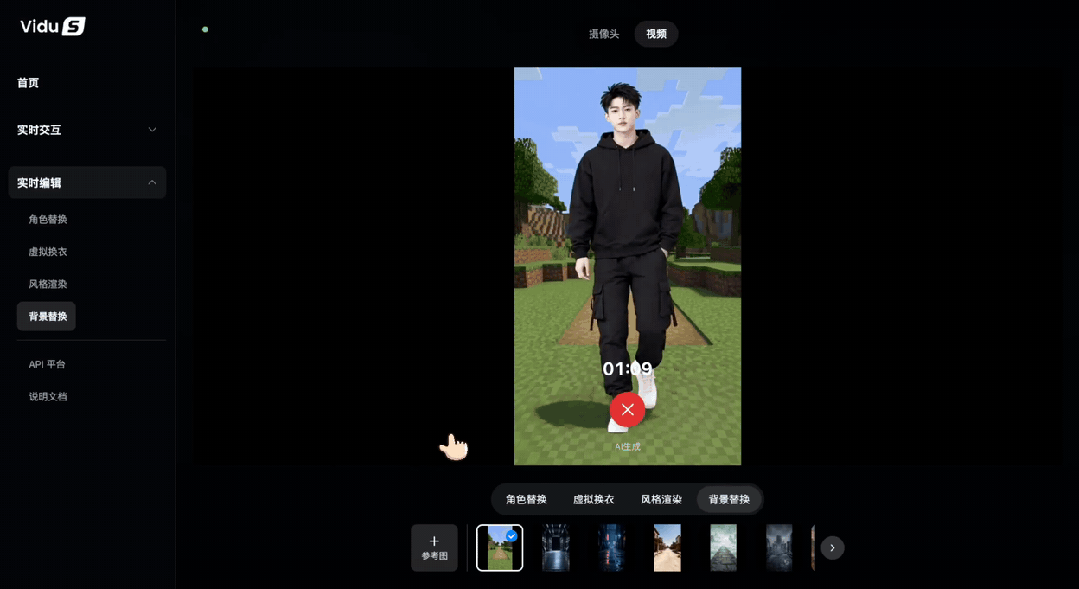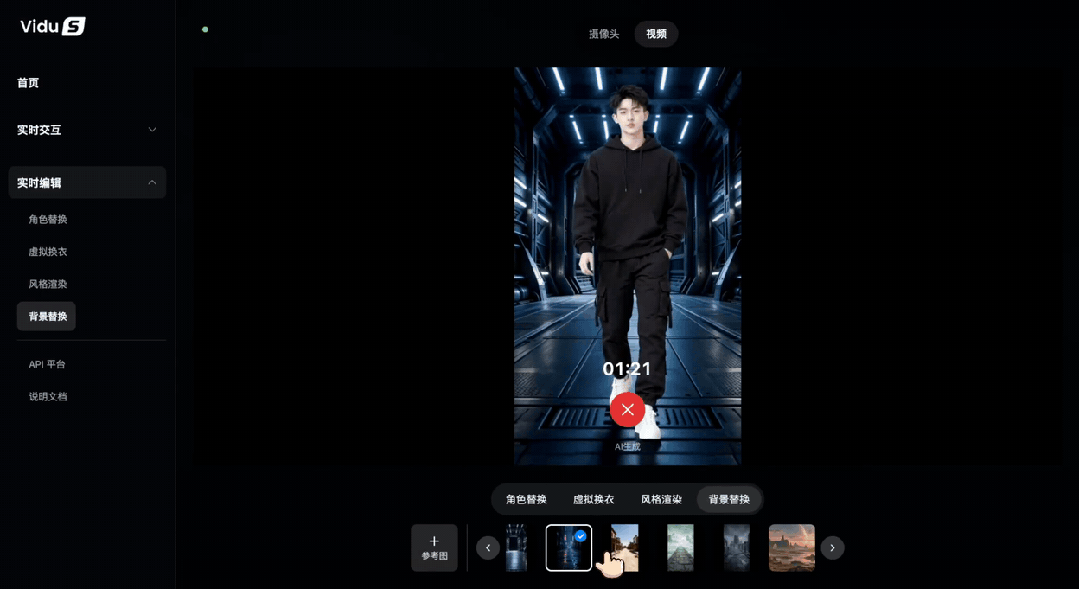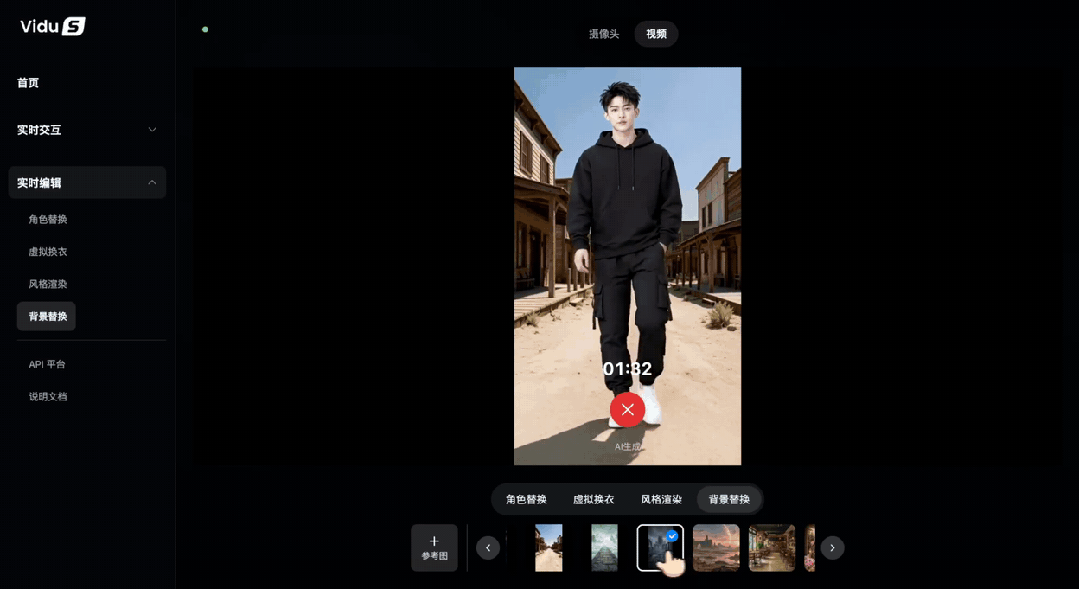
实时编辑的换装、换风格、换背景、换角色,全都能在播放过程中进行。
Vidu S2 现在在 Vidu 的网页版、APP 和小程序都可以直接体验了。在这里:vidu.cn/vidu-stream
技术报告:https://arxiv.org/pdf/2609.11638
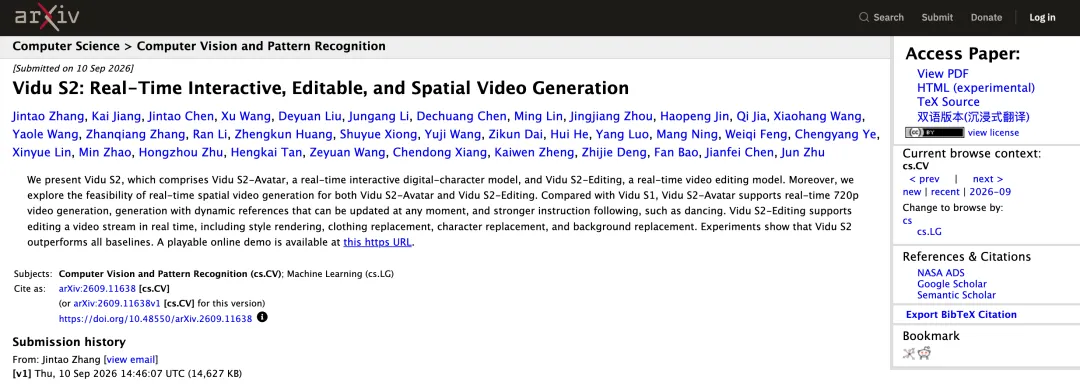
API平台:
http://platform.vidu.cn/vidu-stream/doc
我不想简简单单定位 Vidu S2 就是什么 “会说话的数字人”,这样对它来说太片面了。
它是视频开始之后,角色能持续回复,画面也还能继续改的实时模型。
无论是长时间连续生成时一致性的维持,对指令反馈的准确性,还是响应速度,都是很不错的。
在前面很多案例中大家也可以看到,在虚拟直播、智能服务、教育陪伴和实时内容创作等场景中,它都展现出了明确的应用价值。
不论是从单纯地想要整活、做一些好玩有趣的尝试,还是作为生产力方向去探索更多企业工作场景,它都有非常多的可能。大家感兴趣的话可以直接去体验。
好了,今天的分享就到这里啦,如果大家也有尝试 Vidu S2,欢迎评论区一起交流你的使用感受。如果内容对大家有用的话,欢迎在下方 👍🏻 和 🌸 鼓励,期待你的猛猛三连,这对阿真真的很重要~
下期见~
复制本文链接 文章为作者独立观点不代表优设网立场,未经允许不得转载。
阿真Irene
308.5w人气 68文章
发评论!每天赢奖品
点击 登录 后,在评论区留言,系统会随机派送奖品
2012年成立至今,是国内备受欢迎的设计师平台,提供奖品赞助 联系我们
用户体验增长
已累计诞生 795 位幸运星
发表评论
↓ 下方为您推荐了一些精彩有趣的文章热评 ↓